Micro1 توظّف أشخاصًا حول العالم لتدريب الروبوتات البشرية، فيما يحتاج سوق الذكاء الاصطناعي إلى اختبارات جديدة
مع تسارع نمو سوق الروبوتات البشرية، تدفع Micro1 وScale AI وDoorDash أموالًا لأشخاص مقابل تصوير مهام منزلية اعتيادية، من كيّ الملابس إلى غسل الصحون. تحتاج الروبوتات إلى هذه المقاطع لتتدرّب في العالم الحقيقي، لكن مع نشوء سوق البيانات الجديد تتزايد الأسئلة حول الخصوصية والموافقة، وحول جودة اختبارات الذكاء الاصطناعي نفسها، إذ لم تعد الدرجات المرتفعة في الاختبارات المعيارية (benchmarks) تتطابق في كثير من الأحيان مع الفائدة الفعلية في سير العمل. تُجمع هذه المقاطع عبر متعاقدين يصوّرونها من منظور الشخص الأول، ثم تُراجَع وتُوسَم وتتحول إلى مجموعات بيانات تشتريها شركات الروبوتات. ويرى مراقبون أن حجم الطلب في السوق لا يزال أكبر بكثير من المعروض، حتى مع مئات الآلاف من ساعات الفيديو. وفي موازاة ذلك، تدعو الباحثة أنجيلا أريستيدو إلى تقييم الأنظمة داخل المؤسسات وعلى مدى زمني طويل، لا على مهام معزولة. فالنتيجة العالية في اختبار معياري لا تعني بالضرورة أن الأداة ستسرّع عمل مستشفى أو مستودع أو خدمة دعم.
معالج بواسطة الذكاء الاصطناعي من MIT Technology Review؛ بتحرير Hamidun News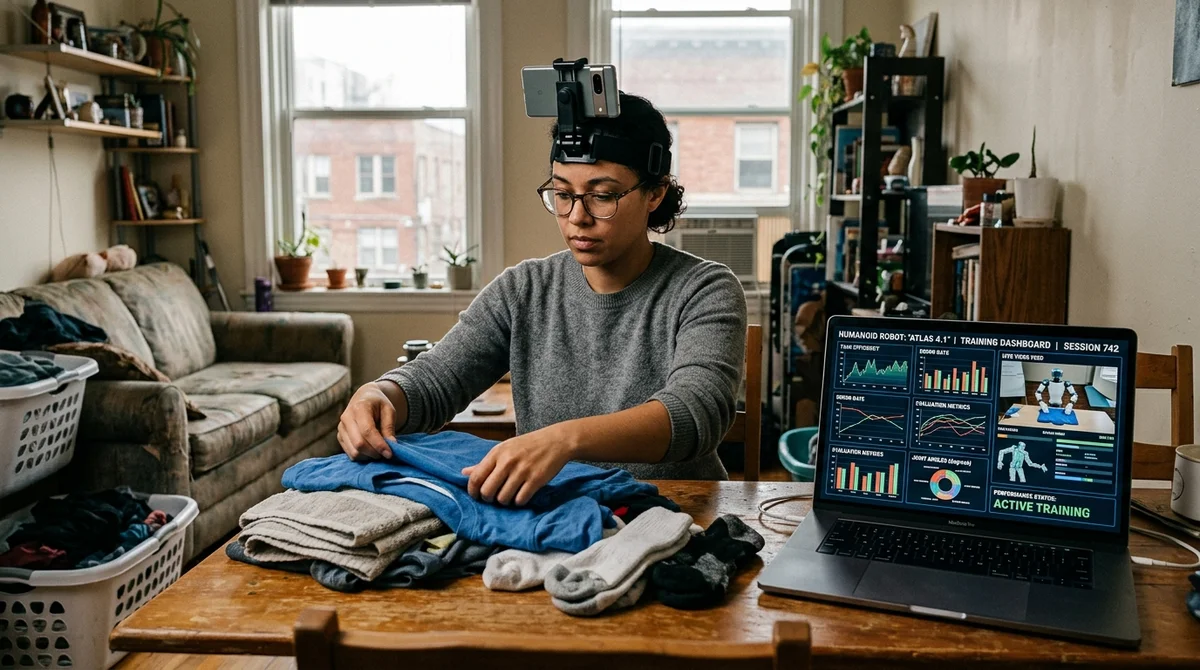
لم يعد سوق الذكاء الاصطناعي المجسَّد (embodied AI) يصطدم بحدود العتاد وحده، بل بالبيانات البشرية أيضًا: آلاف الأشخاص حول العالم يصوّرون بالفيديو كيف يغسلون الملابس ويكوونها وينظّفون منازلهم، لتدريب الروبوتات البشرية. وفي هذا السياق يرفع باحثون صوتهم بأن اختبارات الذكاء الاصطناعي المعتادة لا تقول شيئًا يُذكر عن كيفية تصرّف هذه الأنظمة في العمل الفعلي.
كيف تُدرَّب الروبوتات البشرية
من أبرز الشركات في هذه الطبقة الجديدة من السوق شركة Micro1. فهي توظّف متعاقدين في أكثر من 50 دولة، بينها نيجيريا والهند والأرجنتين، ليسجّلوا أفعالًا منزلية من منظور الشخص الأول: طيّ الملابس، وغسل الصحون، ومسح الطاولة، وصبّ الماء، وفتح الثلاجة. وللقيام بذلك يثبّت المتعاقدون هاتف iPhone على رؤوسهم ويصوّرون مقاطع قصيرة تظهر فيها أيديهم في الإطار. بعد ذلك تخضع المقاطع للمراجعة والوسم، ثم تدخل في مجموعات بيانات تشتريها شركات الروبوتات.
منطق هذا النموذج بسيط: النماذج اللغوية الكبيرة اكتفت بالإنترنت، أما الروبوتات البشرية فتحتاج إلى العالم المادي الحقيقي. تساعد المحاكاة في التدرّب على الحركات، لكنها لا تنقل فوضى الشقة العادية: اختلاف الإضاءة، والمطابخ الضيقة، والأسطح الزلقة، وعشرات أنواع الأشياء وطرق التعامل معها. ولهذا لا تظهر في السوق Micro1 وScale AI، التي جمعت أكثر من 100 ألف ساعة من هذه المواد، فحسب، بل قنوات جديدة أيضًا مثل DoorDash Tasks. ففي 19 مارس 2026 أطلقت DoorDash رسميًا مشروعًا تجريبيًا يُدفع فيه للمنفّذين مقابل تصوير أفعال منزلية وتسجيلات صوتية لأغراض الذكاء الاصطناعي والروبوتات. وحتى مئات الآلاف من ساعات الفيديو لا تبدو بعدُ سقفًا لحاجة السوق.
«الأمر سيستغرق وقتًا أطول مما يعتقد كثيرون»، يقول خبير الروبوتات كين غولدبرغ.
ثمن هذه البيانات
يرى كثير من المنفّذين في هذا العمل دخلًا إضافيًا جيدًا: فأجر يبلغ نحو 15 دولارًا في الساعة يبدو تنافسيًا في عدد من البلدان. لكن العمل يتحول سريعًا إلى روتين رتيب. فعلى المشاركين تصوير أفعال متشابهة مرارًا وتكرارًا، وابتكار سيناريوهات جديدة ضمن شقة صغيرة، والحرص على أن يطابق التسجيل التعليمات. ويروي أحد العاملين في دلهي أن مقطعًا مفيدًا مدته خمس عشرة دقيقة قد يستغرق منه قرابة ساعة، لأن عدد المهام المختلفة التي يمكن تصويرها في البيت محدود.
- يُثبَّت iPhone أو أي هاتف ذكي متوافق آخر عند مستوى الرأس
- تُسجَّل المقاطع من منظور الشخص الأول، وتكون عادةً بمدة 1–2 دقيقة
- يجب أن تبقى اليدان والجسم المستهدف في الإطار طوال الوقت تقريبًا
- المطلوب تنويع الإضاءة والغرف والأسطح والأشياء
- يُحاوَل تجنّب إظهار الوجوه والأسماء وغيرها من البيانات الشخصية
السؤال الأهم هنا ليس الرتابة، بل الخصوصية. فحتى لو لم يظهر الوجه في الإطار، تبقى في الفيديو تفاصيل الديكور الداخلي، والأدوية في المطبخ، وأغراض الأطفال، والروتين اليومي، وجيران ظهروا في الخلفية بالصدفة. ومع ذلك لا يعرف المنفّذون في كثير من الأحيان لمن تُباع تسجيلاتهم لاحقًا، ولا كم من الوقت تُحفظ، ولا إن كان بالإمكان طلب حذفها. وتقول الباحثة ياسمين كوتوري صراحةً إن على الشركات أن تشرح للناس مسبقًا إلى أين قد تصل هذه التقنية وكيف ستنعكس عليهم في المستقبل.
لماذا تفشل الاختبارات
بالتوازي مع سباق البيانات، يحتدم جدل آخر حول كيفية قياس جودة الذكاء الاصطناعي أصلًا. وترى الباحثة أنجيلا أريستيدو أن القطاع عاش طويلًا بمنطق الامتحان المدرسي، حيث تُقارَن النماذج بالإنسان في مهمة معزولة لها إجابة صحيحة أو خاطئة. أما في الحياة فنادرًا ما يحدث ذلك. إذ يُدمَج الذكاء الاصطناعي في الفرق واللوائح والعمليات الطويلة، حيث لا تهمّ الدقة والسرعة وحدهما، بل أيضًا تأثير النظام في تنسيق عمل الأفراد، والعبء الواقع عليهم، والثقة، وعدد الأخطاء في الخطوات اللاحقة.
وتقترح أريستيدو بدلًا من ذلك نهج HAIC، أي التقييم السياقي للتفاعل بين الإنسان والذكاء الاصطناعي (Human–AI, Context-Specific Evaluation). وفكرته أن يُختبَر عمل النظام داخل المؤسسة وعلى أفق زمني طويل، لا النموذج وهو معزول عن محيطه. ففي أمثلتها، بدت أنظمة ذكاء اصطناعي طبية جيدة في الاختبارات، لكنها أبطأت العمل في المستشفيات، لأن الأطباء اضطروا إلى مواءمة مخرجاتها مع معايير الإبلاغ المحلية ومتطلبات الجهات التنظيمية. ويغيّر هذا النهج التركيز على عدة محاور في آن واحد:
- من المهمة الفردية إلى العمل الجماعي وسير العمل
- من الاختبار لمرة واحدة إلى الأثر على المدى البعيد
- من الدقة المجردة إلى جودة التنسيق وكشف الأخطاء
- من الإجابة المنفردة إلى العواقب قبل استخدامها وبعده
بالنسبة إلى الشركات، هذه فكرة غير مريحة لكنها مفيدة. فالدرجة المرتفعة في اختبار معياري لا تعني بعدُ أن الأداة ستسرّع عمل مستشفى أو مستودع أو خدمة دعم أو منظمة إنسانية. وفي إحدى الحالات التي تسوقها أريستيدو، جرى تقييم النظام على مدى 18 شهرًا داخل عمليات حقيقية، مع تتبّع منفصل لمدى سهولة ملاحظة الناس لأخطائه وتصحيحها. ولم يكشف إلا هذا النوع من التحقق عن آليات الحماية المطلوبة أصلًا قبل التوسع في الاعتماد.
ماذا يعني ذلك
ثمة استنتاج مشترك في قصة مدرّبي الروبوتات المنزليين وفي الجدل حول الاختبارات المعيارية الجديدة: صناعة الذكاء الاصطناعي تعتمد أقل فأقل على العروض التوضيحية الجذابة، وأكثر فأكثر على جودة البنية التحتية الخفية. ولن يكسب السباق مَن يملك الروبوت الأكثر إبهارًا أو الدرجة الأعلى في الاختبارات فحسب، بل مَن يستطيع جمع بيانات حقيقية بصورة أخلاقية، وشرح قواعد التعامل معها بوضوح، وإثبات فائدة النظام داخل العمليات الفعلية، لا على المسرح فقط.
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول كيف تُدرَّب الروبوتات البشرية؟
من أبرز الشركات في هذه الطبقة الجديدة من السوق شركة Micro1. فهي توظّف متعاقدين في أكثر من 50 دولة، بينها نيجيريا والهند والأرجنتين، ليسجّلوا أفعالًا منزلية من منظور الشخص الأول: طيّ الملابس، وغسل الصحون، ومسح الطاولة، وصبّ الماء، وفتح الثلاجة. وللقيام بذلك يثبّت المتعاقدون هاتف iPhone على رؤوسهم ويصوّرون مقاطع قصيرة تظهر فيها أيديهم في الإطار. بعد ذلك تخضع المقاطع للمراجعة والوسم، ثم تدخل في مجموعات بيانات تشتريها شركات الروبوتات. منطق هذا النموذج بسيط: النماذج اللغوية الكبيرة اكتفت بالإنترنت، أما الروبوتات البشرية فتحتاج إلى العالم المادي الحقيقي. تساعد المحاكاة في التدرّب
ما أبرز التفاصيل حول ثمن هذه البيانات؟
يرى كثير من المنفّذين في هذا العمل دخلًا إضافيًا جيدًا: فأجر يبلغ نحو 15 دولارًا في الساعة يبدو تنافسيًا في عدد من البلدان. لكن العمل يتحول سريعًا إلى روتين رتيب. فعلى المشاركين تصوير أفعال متشابهة مرارًا وتكرارًا، وابتكار سيناريوهات جديدة ضمن شقة صغيرة، والحرص على أن يطابق التسجيل التعليمات. ويروي أحد العاملين في دلهي أن مقطعًا مفيدًا مدته خمس عشرة دقيقة قد يستغرق منه قرابة ساعة، لأن عدد المهام المختلفة التي يمكن تصويرها في البيت محدود. يُثبَّت iPhone أو أي هاتف ذكي متوافق آخر عند مستوى الرأس تُسجَّل المقاطع من منظور الشخص الأول، وتكون عادةً بمدة 1–2 دقيقة يجب أن تبقى اليد
ما أبرز التفاصيل حول لماذا تفشل الاختبارات؟
بالتوازي مع سباق البيانات، يحتدم جدل آخر حول كيفية قياس جودة الذكاء الاصطناعي أصلًا. وترى الباحثة أنجيلا أريستيدو أن القطاع عاش طويلًا بمنطق الامتحان المدرسي، حيث تُقارَن النماذج بالإنسان في مهمة معزولة لها إجابة صحيحة أو خاطئة. أما في الحياة فنادرًا ما يحدث ذلك. إذ يُدمَج الذكاء الاصطناعي في الفرق واللوائح والعمليات الطويلة، حيث لا تهمّ الدقة والسرعة وحدهما، بل أيضًا تأثير النظام في تنسيق عمل الأفراد، والعبء الواقع عليهم، والثقة، وعدد الأخطاء في الخطوات اللاحقة. وتقترح أريستيدو بدلًا من ذلك نهج HAIC، أي التقييم السياقي للتفاعل بين الإنسان والذكاء الاصطناعي (Human–AI, Conte
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.