MIT تطوّر منهجية لكشف التمييز في أنظمة دعم القرار المعتمدة على الذكاء الاصطناعي
طوّر باحثو MIT إطارًا لاختبار أخلاقيات أنظمة الذكاء الاصطناعي المستقلة. وتحدد هذه الأداة بدقة المواقف التي تعامل فيها أنظمة دعم القرار المعتمدة على الذكاء الاصطناعي الناس معاملة غير عادلة. يغطي المنهج مجالات الرعاية الصحية والإقراض والعدالة الجنائية، أي كل موضع تتخذ فيه الخوارزميات قرارات تمس حياة أشخاص حقيقيين. ويتيح الإطار للمطورين والجهات التنظيمية كشف التحيّز قبل نشر الأنظمة.
معالج بواسطة الذكاء الاصطناعي من MIT News؛ بتحرير Hamidun News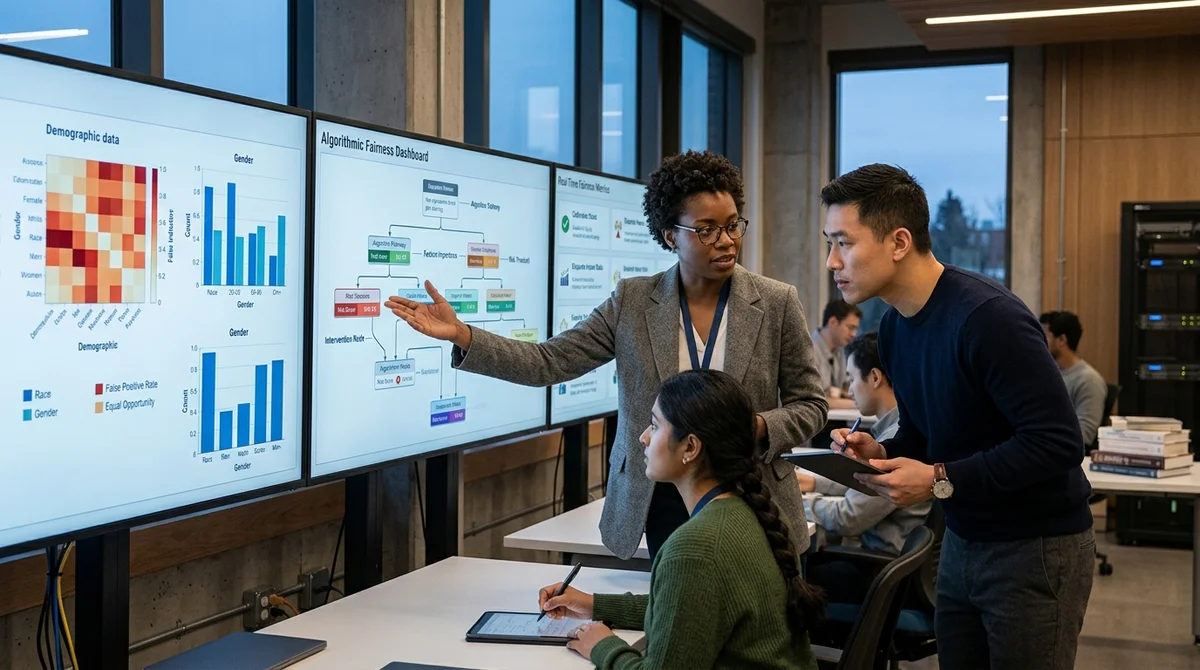
طوّر باحثو معهد ماساتشوستس للتكنولوجيا إطارًا للاختبار يكشف بصورة منهجية المواقف التي تتخذ فيها أنظمة الذكاء الاصطناعي المستقلة قرارات غير عادلة بحق أشخاص بعينهم ومجتمعات بأكملها. ويسدّ هذا العمل إحدى الثغرات الرئيسية في أدوات تقييم أخلاقيات الذكاء الاصطناعي، وهي غياب منهجية قادرة على رصد التمييز لا على مستوى الإحصاءات فحسب، بل في سيناريوهات محددة أيضًا.
أين يُلحق التحيّز الضرر
تتغلغل أنظمة دعم القرار، أي الخوارزميات التي تساعد في اتخاذ القرارات في الرعاية الصحية والإقراض والتعليم والتوظيف والعدالة الجنائية، بعمق متزايد في العمليات اليومية. وفي هذه المجالات تحديدًا يُحدث التحيّز الخوارزمي أكبر قدر من الضرر الملموس. فقد يُرفض طلب الرهن العقاري لشخص ما، أو تُستبعد سيرته الذاتية قبل مرحلة المقابلة، أو تُفرض عليه عقوبة أشد، وكل ذلك دون مبرر واضح، وغالبًا دون إمكانية للطعن في القرار.
قيود الأساليب الحالية
تقيس أساليب تدقيق أنظمة الذكاء الاصطناعي المعتمدة حاليًا، في الغالب، التفاوتات الديموغرافية في النتائج المجمّعة. ويتيح هذا التحليل اكتشاف الانحرافات المنهجية الكبيرة، لكنه يغفل حالات التمييز الدقيقة المرتبطة بالسياق. فقد يُظهر النظام تكافؤًا إحصائيًا في المجمل، بينما يقدّم بصورة منهجية توصيات غير مواتية لأفراد من فئات معينة عند توافر ظروف محددة في الحالة. أما مقاييس العدالة التقليدية فلا ترصد هذه الانتهاكات المحلية إطلاقًا.
نهج السيناريوهات لدى MIT
يعالج إطار MIT هذه المشكلة عبر نهج قائم على السيناريوهات. فتولّد الأداة تلقائيًا مجموعات اختبار، أي مواقف تتغير فيها معايير محددة: الخصائص الديموغرافية لمقدّم الطلب، وتاريخ طلباته السابقة، وصياغة الأسئلة، والسياق المصاحب. ثم يحلل النظام استجابة نموذج الذكاء الاصطناعي لهذه التغيرات، ويرصد الأنماط الدالة على معاملة غير عادلة.
والفارق الجوهري أن الإطار لا يبحث عن الفجوات بين المجموعات الديموغرافية على مستوى الإحصاءات فحسب، بل عن المحفزات الظرفية المحددة التي تستدعي استنتاجات متحيزة. وفي اختبارات أُجريت على عدة أنظمة ذكاء اصطناعي حقيقية، أكد الباحثون أن التحيّز يتركز في كثير من الأحيان في سيناريوهات ضيقة ومحددة يغفلها التدقيق القياسي. ويعني ذلك أن المطورين والجهات التنظيمية الذين يعتمدون على المقاييس المجمّعة وحدها قد يشعرون بأمان زائف، بينما يستمر التمييز الفعلي على مستوى الحالات الفردية.
التطبيق العملي والتنظيم
صمّم فريق MIT الأداة عمدًا لتكون عملية، لا بحثية فحسب. فالمنهجية متوافقة مع المعايير القائمة للذكاء الاصطناعي المسؤول، ولا سيما NIST AI Risk Management Framework، ويمكن من حيث المبدأ دمجها في إجراءات الفحص الإلزامية للأنظمة قبل طرحها في السوق. ويصف المؤلفون سيناريوهات استخدام محتملة، من الفحوص الداخلية في الشركات المطورة إلى التدقيق المستقل من جانب الجهات التنظيمية. ويأتي البحث في ظل ضغط تنظيمي متزايد على قطاع الذكاء الاصطناعي. ففي أوروبا يُلزم AI Act مزوّدي الأنظمة عالية المخاطر بإجراء تقييم للمخاطر والاحتفاظ بالتوثيق. وفي الولايات المتحدة سنّت عدة ولايات بالفعل تشريعات تتعلق بالمساءلة الخوارزمية، فيما تتجه الوكالات الفيدرالية بنشاط متزايد إلى مسألة التمييز الخوارزمي. وفي هذا السياق، تمثّل أدوات الاختبار الموحدة تحديدًا ما تفتقر إليه الجهات التنظيمية حاليًا.
الخلاصة
يخلص عمل MIT إلى نتيجة بسيطة لكنها مهمة: أخلاقيات الذكاء الاصطناعي ليست مسألة نوايا وتصريحات فحسب، بل مسألة تحقّق أيضًا. فمن دون أدوات قادرة على كشف الظلم في مواقف محددة، يظل حتى أكثر المطورين حرصًا عرضة لإطلاق نظام تشوبه انتهاكات لم تُلاحَظ. ويقدّم الإطار الجديد خطوة ملموسة نحو جعل الوعود بذكاء اصطناعي عادل قابلة للتحقق عمليًا.
- 27 أكتوبر 2026Anthropic تدعو إلى تقليص الوكلاء الفرعيين: حلقة واحدة مع المهارات تتفوق على المنسّقين
- 27 أكتوبر 2026Anthropic تنصح بالتخلص من نصف الوكلاء الفرعيين: حلقة واحدة أثبتت أنها أسرع بمرتين
- 26 أكتوبر 2026Axios: كبار مديري Anthropic وOpenAI يحاكون سرًّا سيناريو كارثة ناجمة عن الذكاء الاصطناعي
- 26 أكتوبر 2026Getty Images تعلن الإفلاس تمهيدًا للتحول إلى شركة خاصة: السهم يهوي 68%
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول أين يُلحق التحيّز الضرر؟
تتغلغل أنظمة دعم القرار، أي الخوارزميات التي تساعد في اتخاذ القرارات في الرعاية الصحية والإقراض والتعليم والتوظيف والعدالة الجنائية، بعمق متزايد في العمليات اليومية. وفي هذه المجالات تحديدًا يُحدث التحيّز الخوارزمي أكبر قدر من الضرر الملموس. فقد يُرفض طلب الرهن العقاري لشخص ما، أو تُستبعد سيرته الذاتية قبل مرحلة المقابلة، أو تُفرض عليه عقوبة أشد، وكل ذلك دون مبرر واضح، وغالبًا دون إمكانية للطعن في القرار.
ما أبرز التفاصيل حول قيود الأساليب الحالية؟
تقيس أساليب تدقيق أنظمة الذكاء الاصطناعي المعتمدة حاليًا، في الغالب، التفاوتات الديموغرافية في النتائج المجمّعة. ويتيح هذا التحليل اكتشاف الانحرافات المنهجية الكبيرة، لكنه يغفل حالات التمييز الدقيقة المرتبطة بالسياق. فقد يُظهر النظام تكافؤًا إحصائيًا في المجمل، بينما يقدّم بصورة منهجية توصيات غير مواتية لأفراد من فئات معينة عند توافر ظروف محددة في الحالة. أما مقاييس العدالة التقليدية فلا ترصد هذه الانتهاكات المحلية إطلاقًا.
ما أبرز التفاصيل حول نهج السيناريوهات لدى MIT؟
يعالج إطار MIT هذه المشكلة عبر نهج قائم على السيناريوهات. فتولّد الأداة تلقائيًا مجموعات اختبار، أي مواقف تتغير فيها معايير محددة: الخصائص الديموغرافية لمقدّم الطلب، وتاريخ طلباته السابقة، وصياغة الأسئلة، والسياق المصاحب. ثم يحلل النظام استجابة نموذج الذكاء الاصطناعي لهذه التغيرات، ويرصد الأنماط الدالة على معاملة غير عادلة. والفارق الجوهري أن الإطار لا يبحث عن الفجوات بين المجموعات الديموغرافية على مستوى الإحصاءات فحسب، بل عن المحفزات الظرفية المحددة التي تستدعي استنتاجات متحيزة. وفي اختبارات أُجريت على عدة أنظمة ذكاء اصطناعي حقيقية، أكد الباحثون أن التحيّز يتركز في كثير من
Delegate Deep Research, Coding & Multi-Step Workflows to Nomad Agent
Deploy autonomous task execution with Nomad Agent (agent.nomadnet.ai) — automated web research, data synthesis, code generation, and MCP tool orchestration.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.