OpenAI وAnthropic وGemini: كيف يخفّض التخزين المؤقت للاستدلال تكلفة نماذج LLM وزمن استجابتها
أصبح التخزين المؤقت للاستدلال تحسينًا أساسيًا لخدمات LLM: فهو يقلّل زمن الاستجابة، ويخفّف الحسابات المتكررة، ويخفّض تكلفة الرموز بصورة ملحوظة. والقاعدة العملية الأهم في الدليل الجديد هي البدء باستخدام prefix caching مع موجّهات النظام الطويلة والثابتة، وعدم اللجوء إلى semantic caching إلا حيث يطرح المستخدمون بكثافة أسئلة متشابهة بصياغات مختلفة.
معالج بواسطة الذكاء الاصطناعي من Machine Learning Mastery؛ بتحرير Hamidun News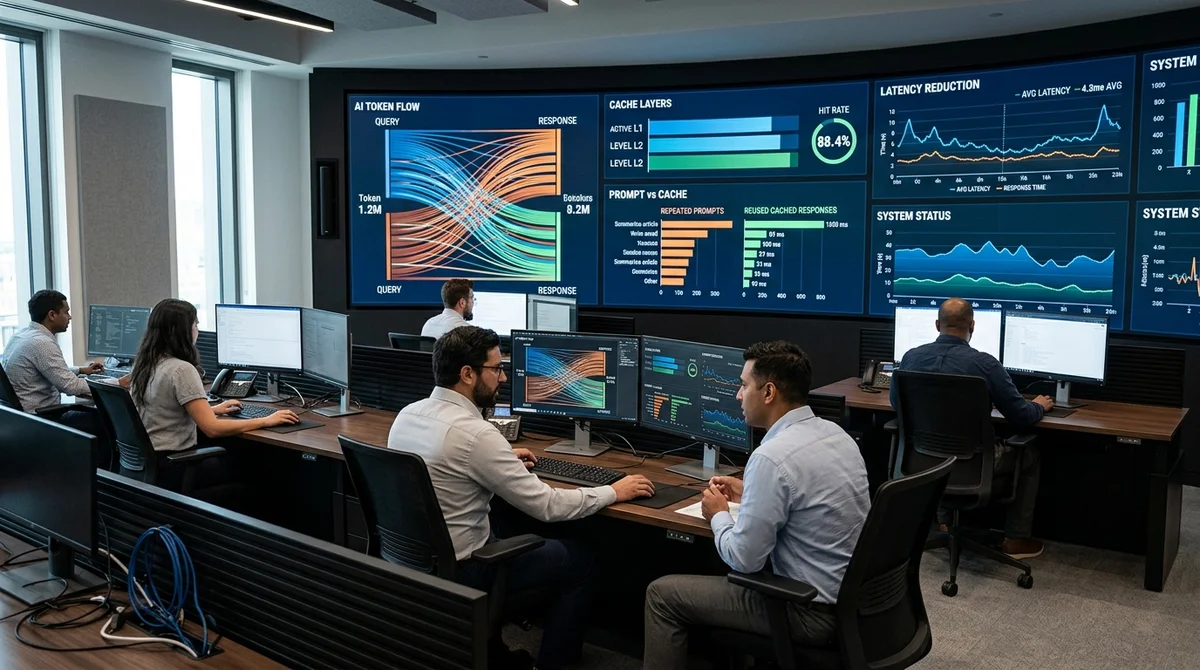
يتحوّل التخزين المؤقت للاستدلال بسرعة إلى واحدة من أكثر التقنيات عملية في التعامل مع النماذج اللغوية الكبيرة: فهو يخفّض تكلفة الطلبات، ويقلّل زمن الاستجابة، ويتيح عدم إعادة حساب الأجزاء نفسها من الموجّه مرة بعد أخرى. وبالنسبة إلى الخدمات الإنتاجية ذات التعليمات الطويلة لنظام النموذج والطلبات المتكررة، لم يعد هذا تحسينًا دقيقًا، بل أداة أساسية لتوفير التكاليف.
جوهر المقاربة أن LLM تنفق جزءًا ملحوظًا من مواردها لا على «الإجابة الذكية»، بل على إعادة معالجة سياق مألوف سبق أن عالجته. فإذا كان للتطبيق system prompt واحد ثابت، أو مستندات مشتركة، أو أمثلة few-shot، أو أسئلة نمطية، فإن النموذج من دون ذاكرة مؤقتة يقطع هذا المسار من جديد في كل مرة. أما inference caching فيحفظ نتائج هذه الحسابات ويعيد استخدامها عندما يتطابق الطلب التالي تطابقًا كاملًا، أو يقترب منه في المعنى بدرجة كافية. والنتيجة أن النظام ينفق رموزًا أقل، ويردّ على المستخدم أسرع، ويصبح توسيعه لتحمّل الأحمال الكبيرة أسهل.
على المستوى الأساسي يعمل التخزين المؤقت لـ KV. فأثناء التوليد، يحفظ النموذج رمزًا برمز الحالات الداخلية لآلية attention، أي أزواج key وvalue، كي لا يعيد حسابها في كل خطوة لاحقة من فك الترميز. ويحدث ذلك تلقائيًا في معظم محركات الاستدلال الحديثة تقريبًا، ويسرّع طلبًا واحدًا بعينه. وعادة لا يحتاج المستخدم إلى تفعيل أي شيء يدويًا، لكن من المهم أن يفهم أن التحسينات الأبرز على المستوى الأعلى مبنية على هذه الآلية تحديدًا. وبعبارة أخرى، KV-cache هو الأساس الذي يزيل العمل الزائد داخل استدعاء واحد للنموذج.
الطبقة التالية هي prefix caching، ويسمّيه المزوّدون أيضًا prompt caching أو context caching. فكرته بسيطة: إذا كانت لطلبات مختلفة بداية واحدة، مثل تعليمات نظام طويلة، أو كتلة قواعد، أو مستند مرجعي، أو مجموعة أمثلة، فيمكن معالجتها مرة واحدة وإعادة استخدامها في الاستدعاءات اللاحقة. لكن هناك شرطًا صارمًا: يجب أن يتطابق البادئ بايتًا ببايت. فمسافة زائدة، أو علامة ترقيم مغيَّرة، أو تاريخ جديد في مطلع الموجّه، أو ترتيب غير مستقر لمفاتيح JSON، كلها كفيلة بإفشال cache hit بسهولة. ولذلك يُفضَّل وضع المحتوى الثابت في البداية، ونقل كل المتغيرات، أي رسالة المستخدم وsession ID والتاريخ الحالي، إلى النهاية.
ولهذا السبب بالتحديد أصبحت هذه التقنية جزءًا من واجهات API لدى اللاعبين الكبار: فـ Anthropic تمنح المطوّرين تحكمًا صريحًا في الكتل المخزّنة مؤقتًا، وOpenAI تطبّق prefix caching تلقائيًا على الموجّهات الطويلة، وGoogle Gemini تقدّم آلية منفصلة لحفظ السياق. أما في البيئات المستضافة ذاتيًا فيدعم vLLM وSGLang منطقًا مشابهًا.
الطبقة الثالثة هي semantic caching. في هذه الحالة لا يخزّن النظام الحالات الوسيطة للنموذج، بل أزواج «طلب-إجابة»، ويبحث عن التطابقات من حيث المعنى عبر embeddings وقاعدة بيانات متجهية. فإذا سأل المستخدم شيئًا يكاد يطابق ما سُئل سابقًا، يستطيع التطبيق إعادة إجابة جاهزة من دون استدعاء LLM أصلًا. وهذا النهج مفيد خصوصًا للأسئلة الشائعة FAQ، وروبوتات الدعم، والخدمات الجماهيرية التي يصوغ فيها الناس الأسئلة نفسها بكلمات مختلفة. لكن هذا التوفير له ثمن في صورة بنية تحتية إضافية: تلزم embeddings وبحث متجهي وTTL وضبط دقيق لعتبة التشابه، وإلا ازداد خطر الإجابات القديمة أو غير ذات الصلة. لذلك لا يُبرَّر semantic caching في كل مكان، بل أولًا حيث يوجد تدفق كبير من الطلبات المتشابهة واحتمال مرتفع لإعادة استخدام إجابة سبق توليدها.
ماذا يعني ذلك عمليًا؟ التخزين المؤقت لـ KV يعمل أصلًا من تلقاء نفسه، وprefix caching يمنح عادة أسرع مكسب وأكثره أمانًا في الإنتاج، أما semantic caching فلا ينبغي إضافته إلا حيث يغطّي تكرار الأسئلة فعلًا تكلفة البنية التحتية الإضافية. وبالنسبة إلى معظم الفرق، يبدو المسار الأمثل كالتالي: أن تثبّت أولًا بنية الموجّهات، وتنقل كل السياق المشترك إلى البداية، وتحقق نسبة cache hit عالية على مستوى البادئ، ثم تقرر بعد ذلك ما إذا كانت هناك حاجة إلى ذاكرة مؤقتة دلالية. وفي تطبيقات LLM، هذه حالة نادرة ينجح فيها انضباط معماري واحد في خفض النفقات وتسريع المنتج في آن واحد، من دون أن يغيّر تجربة المستخدم تقريبًا.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.