باحثو MIT يعلّمون الذكاء الاصطناعي أن يقول بصدق «لست متأكدًا» ويقلّلون هلوساته
عرض MIT طريقة للحد من إحدى أبرز مشكلات نماذج الاستدلال (reasoning)، وهي الأخطاء المقدَّمة بثقة. تعلّم الطريقة الجديدة RLCR الذكاء الاصطناعي ألا يكتفي بتقديم الإجابة، بل أن يقيّم أيضًا مدى ثقته بها. وفي الاختبارات انخفض خطأ المعايرة بنسبة وصلت إلى 90%، دون أن تتأثر الدقة. تكتسب هذه النتيجة أهمية خاصة في الطب والقانون والمالية، إذ لا يكمن الخطر الأكبر في الخطأ بحد ذاته، بل في خطأ يُقال بثقة مفرطة.
معالج بواسطة الذكاء الاصطناعي من MIT News؛ بتحرير Hamidun News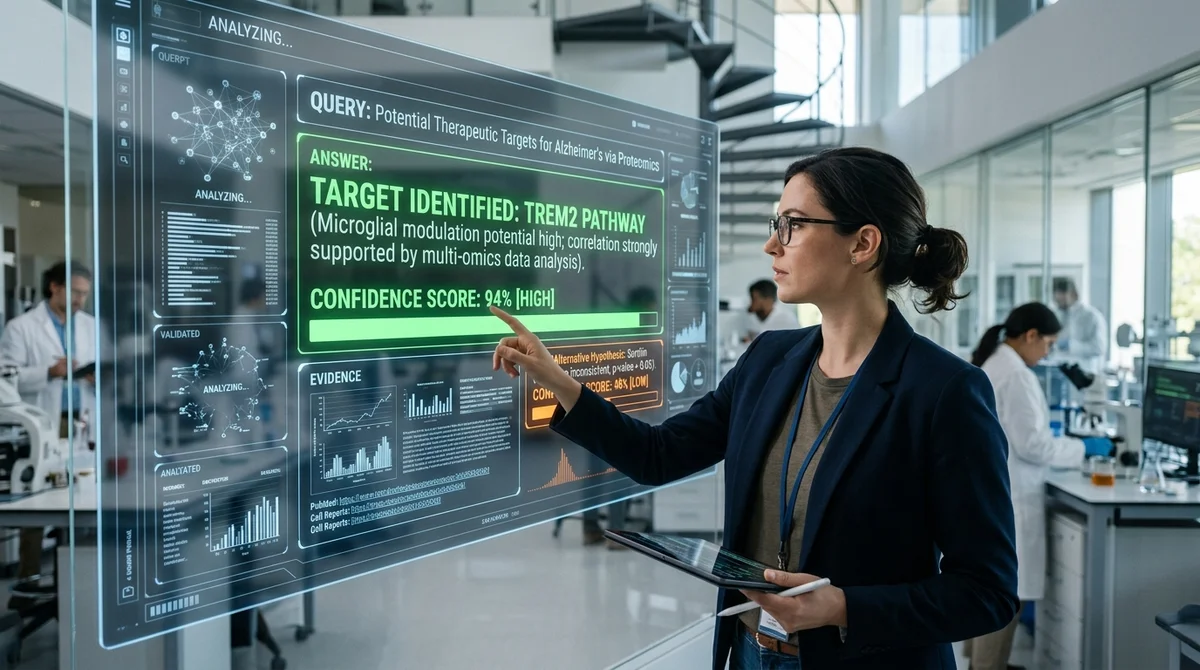
اقترح باحثو MIT طريقة تجعل النماذج اللغوية أكثر صدقًا في إجاباتها بشكل ملحوظ: فلا يكتفي النموذج بحل المسألة، بل يقيّم في الوقت نفسه مدى ثقته باستنتاجه. قد يبدو هذا تعديلًا بسيطًا، لكنه يعالج عمليًا إحدى أكثر مشكلات نماذج الاستدلال (reasoning) الحديثة إزعاجًا، وهي عادة التحدث بنبرة واثقة حتى عندما تكون الإجابة قد جاءت بالتخمين تقريبًا. ولا تخفض المنهجية الجديدة جودة الإجابات نفسها، بل تساعد النموذج، على العكس، على التمييز بين الحالات التي يعرف فيها شيئًا فعلًا والحالات التي كان الأجدر به أن يقرّ فيها بعدم اليقين.
يصف فريق MIT CSAIL المشكلة بصراحة لافتة: النماذج القوية اليوم تتصرف في كثير من الأحيان كأعلى الأصوات في الغرفة. فهي تجيب بالدرجة نفسها من الثقة سواء نجح المنطق أم كان النموذج قد خمّن فحسب. ويرى الباحثون أن السبب كامن في مخطط التعلّم المعزَّز (reinforcement learning) المستخدم حاليًا لتطوير قدرات الاستدلال. ففي الصيغة المعتادة ينال النموذج مكافأة على الإجابة الصحيحة وعقوبة على الإجابة الخاطئة، ولا توجد حالات وسيطة تقريبًا. وإذا وصل النموذج إلى نتيجة صحيحة بالمصادفة، فإنه يُكافأ بالقدر نفسه كما لو استخرج الحل بعناية فعلًا. ومع مرور الوقت يدفع ذلك النظام إلى الإجابة دائمًا، دون أن يترك مساحة لعبارة «لست متأكدًا».
هذا ما حاول MIT إصلاحه في نهج RLCR، أي Reinforcement Learning with Calibration Rewards. فبدلًا من التقييم الثنائي الصرف، أضاف الباحثون إلى دالة المكافأة مكوّنًا آخر هو Brier score، وهو مقياس يقارن الثقة المعلنة بالدقة الفعلية. وعمليًا، يقدّم النموذج بعد سلسلة الاستدلال إجابته مع تقدير رقمي لثقته بها. فإذا أفرط في الثقة وأخطأ، يُعاقَب على ذلك. وإذا قدّم إجابة صحيحة لكنه خفّض ثقته دون مبرر، يؤخذ ذلك في الحسبان أيضًا. ويؤكد المؤلفون أن هذا المخطط يقود رسميًا إلى هدفين معًا: دقة عالية ومعايرة جيدة، أي التطابق بين ما يقوله النموذج عن ثقته ومدى إصابته الفعلية في الواقع.
أُجريت التجارب على نموذج بحجم 7 مليارات معامل. ووفق بيانات MIT، خفّض RLCR خطأ المعايرة بنسبة وصلت إلى 90 بالمئة مقارنة بالتعلّم المعزَّز المعتاد، دون تراجع في الدقة، بل ارتفعت في عدد من الاختبارات. واستمر هذا الأثر لا على المهام التي دُرّب عليها النموذج فحسب، بل على مجموعات بيانات جديدة أيضًا، منها ست مجموعات لم يرها من قبل.
وقارن الباحثون الطريقة على حدة بالنُّهج اللاحقة (post-hoc)، التي تُقدَّر فيها الثقة بعد انتهاء التدريب عبر مصنِّف خارجي. وتفوّق RLCR هنا أيضًا: فبدلًا من إضافة طبقة تجميلية فوق نموذج جاهز، يغيّر سلوك النظام نفسه أثناء التدريب. بل يبيّن فريق MIT أن التعلّم المعزَّز القياسي لا يفشل في تحسين المعايرة فحسب، وإنما يزيدها سوءًا في كثير من الأحيان: يصبح النموذج أقدر، لكنه يغدو في الوقت نفسه أكثر ثقة بنفسه.
وللأمر معنى عملي أيضًا. فإذا ولّد النموذج عدة صيغ للإجابة، يمكن اختيار الصيغة التي يعلن هو نفسه أعلى ثقة بها، أو ترجيح أصوات المرشَّحين بحسب هذا التقدير. وبحسب المؤلفين، يحسّن ذلك الدقة والمعايرة معًا مع ازدياد الحوسبة أثناء الاستدلال (inference).
وثمة نتيجة لافتة أخرى: عندما دُرّبت مصنِّفات منفصلة على مخرجات النموذج، وفّر الاستدلال الصريح حول عدم اليقين الذاتي إشارة إضافية مفيدة، خصوصًا للنماذج الأصغر حجمًا. أي أن محاولة النموذج أن يصوغ بالكلمات ما يعرفه وما لا يعرفه ليست عنصرًا زخرفيًا، بل جزء جوهري من التنبؤ.
ما معنى هذا عمليًا؟ إذا أمكن توسيع نهج RLCR ليشمل نماذج تجارية أكبر، فستتاح للصناعة فرصة لتقليل عدد الأخطاء الصريحة، وكذلك عدد الأخطاء الخطيرة المتخفّية في نبرة واثقة. وتزداد أهمية ذلك في مجالات مثل الطب والقانون والمالية والتحليلات المؤسسية، حيث لا يكفي المستخدم أن يحصل على إجابة، بل يحتاج إلى أن يعرف إلى أي مدى يمكن الوثوق بها.
لا يقدّم عمل MIT مرشّحًا جديدًا يُضاف فوق نموذج مدرَّب مسبقًا، بل فكرة أكثر جذرية: أن يتعلّم الذكاء الاصطناعي لا إيجاد الحل فحسب، بل قياس حدود معرفته بصدق. وقد تكون هذه العادة بالذات من أنفع التحديثات لجيل أنظمة الاستدلال القادم.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.