AWS تستعرض كيفية بناء وكلاء الذكاء الاصطناعي على SageMaker واختبار النماذج عبر MLflow
أصدرت AWS شرحاً عملياً لبناء وكلاء الذكاء الاصطناعي باستخدام Strands Agents SDK مع نماذج منشورة على SageMaker. وتضم المنظومة JumpStart لتشغيل النماذج التأسيسية (foundation models)، وServerless MLflow للتتبّع والمقاييس، إضافة إلى اختبارات A/B بين نسخ النماذج. والفكرة الرئيسية أن الأنظمة القائمة على الوكلاء يمكن بناؤها وقياسها وتحسينها باستمرار على بنية تحتية مُدارة خاصة بالمؤسسة.
معالج بواسطة الذكاء الاصطناعي من AWS Machine Learning Blog؛ بتحرير Hamidun News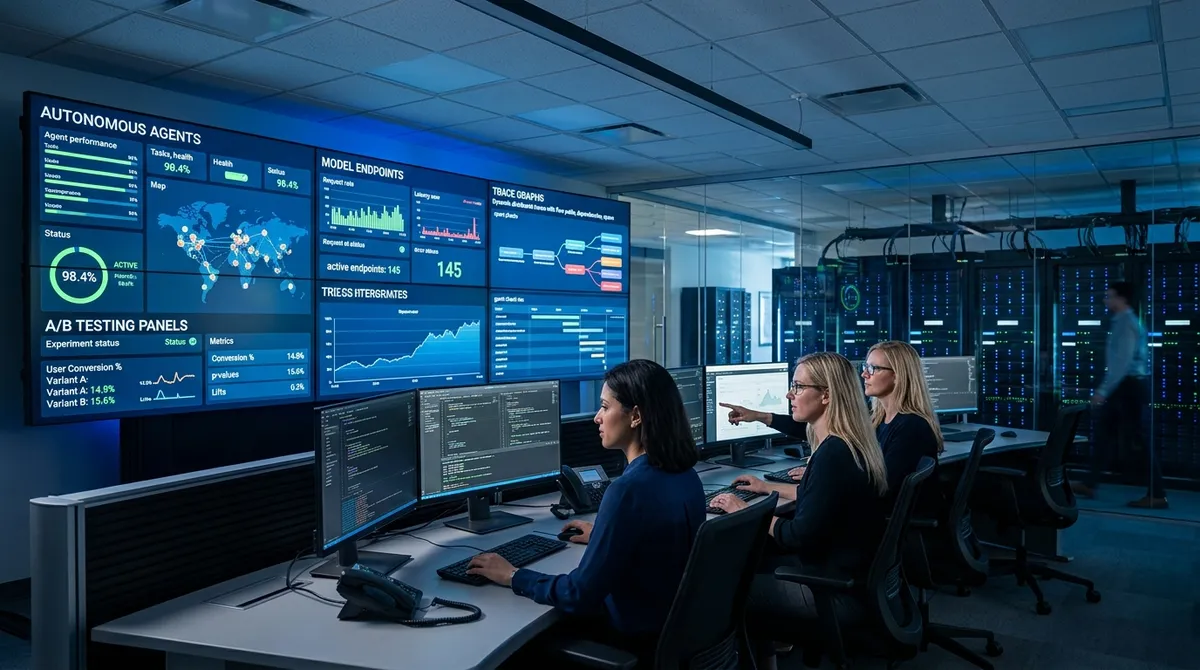
في 27 أبريل 2026 نشرت AWS شرحاً عملياً لكيفية تشغيل وكلاء الذكاء الاصطناعي على بنية تحتية مُدارة خاصة بالمؤسسة، وليس فقط عبر الخدمات المُدارة بالكامل (managed). وعرضت الشركة منظومة تجمع Strands Agents SDK وSageMaker AI وServerless MLflow، يمكن فيها بناء الوكيل بسرعة، ونشره على endpoint، ومراقبة سلوكه في بيئة الإنتاج، ومقارنة عدة نسخ من النموذج دون تغيير البنية العامة. وبالنسبة إلى الفرق التي تهمها السيطرة وكلفة يمكن التنبؤ بها ومتطلبات الأمان، يبدو ذلك محاولة لتحويل الأنظمة القائمة على الوكلاء من طبقة تجريبية إلى عملية MLOps اعتيادية.
يقوم النهج على Strands Agents SDK، وهو إطار مفتوح المصدر لبناء الوكلاء من نموذج وprompt ومجموعة أدوات. في المثال الذي قدّمته AWS، تعرض الشركة أولاً سيناريو أساسياً بنموذج على Bedrock، ثم تنقل الفكرة نفسها إلى نماذج مُشغّلة على SageMaker AI. والنقطة المحورية أن Strands يستطيع التعامل مع inference endpoints في SageMaker بوصفها مزوّد نماذج، شريطة أن يدعم النموذج واجهة chat completions API المتوافقة مع OpenAI.
يستخدم العرض التوضيحي نسختين من Qwen3 من SageMaker JumpStart، بحجم 4B و8B. تُنشر الأولى بوصفها endpoint رئيسياً، ثم يحصل الوكيل على أدوات مثل طلبات HTTP والآلة الحاسبة، ويستطيع تنفيذ المهام النمطية فوق البنية التحتية الخاصة بالنماذج.
لماذا ننقل منطق الوكلاء إلى SageMaker أصلاً، ما دامت السوق مليئة بواجهات API الجاهزة؟ تعتمد AWS على أربع حجج. الأولى هي السيطرة على البنية التحتية: يمكن اختيار الـ instances وإعدادات الشبكة وقواعد التوسّع بدقة بما يناسب زمن الاستجابة المطلوب واتفاقية مستوى الخدمة (SLA). الثانية هي المرونة في اختيار النماذج: إضافة إلى النماذج التأسيسية الجاهزة، يمكن استخدام نماذج مخصصة أو مُعاد تدريبها (fine-tuned)، وكذلك نماذج مفتوحة المصدر. الثالثة هي اقتصاديات أكثر قابلية للتنبؤ مع الأحمال الكبيرة، بفضل endpoints مخصصة وضبط دقيق للموارد. الرابعة هي إطار مؤسسي متكامل حول الوكلاء: تتبّع وإدارة إصدارات واختبارات A/B وتدقيق، وهي أمور لا تلزم في العروض التجريبية بل في بيئة الإنتاج.
وتركّز AWS بصورة خاصة على قابلية المراقبة. لهذا الغرض تُستخدم SageMaker AI Serverless MLflow: تسجّل الخدمة تلقائياً مسارات التنفيذ (execution traces) وخطوات الوكيل واستدعاءات الأدوات والمقاييس، دون أن تضطر الفرقة إلى تزويد الكود يدوياً بقياسات عن بُعد (telemetry) مخصصة. وبعد تفعيل autolog تصل البيانات إلى واجهة MLflow، حيث يمكن الاطلاع على قائمة عمليات التشغيل، وفتح trace محدد، ومشاهدة Agent Loop وشجرة الـ spans ومدخلات كل خطوة ومخرجاتها.
ولا تقتصر أهمية ذلك على تصحيح الأخطاء. فمستوى الشفافية هذا ضروري عندما يبدأ الوكيل باتخاذ قرارات في عمليات أعمال حساسة، وعلى الفريق أن يفهم أين أخطأ تحديداً، ولماذا اختار أداة بعينها، وكيف يتغير سلوكه بعد تحديث النموذج.
أما الجزء الأكثر عملية في المادة فهو اختبار A/B بين نسخ النماذج. تعرض AWS كيفية ربط نسختين إنتاجيتين (production variants) بـ endpoint واحد، وهما في المثال Qwen3 4B وQwen3 8B، وتقسيم حركة المرور بينهما في البداية بنسبة 50 إلى 50. بعد ذلك يمكن إما مقارنة الإجابات في التدفق الحي، أو إنشاء وكيلين منفصلين يتجه كل منهما إلى target variant خاص به. ثم يأتي دور MLflow GenAI evaluation: تجمع الفرقة مجموعة موحدة من حالات الاختبار، وتحدد التوقعات بشأن الحقائق والأدوات المستخدمة، ثم تُمرّر النسختين عبر scorers متماثلة. ويستخدم المثال فحوصاً حتمية (deterministic) إلى جانب مقاييس LLM-as-a-judge مثل correctness وrelevance.
يحوّل هذا السيناريو اختيار النموذج من جدل قائم على الانطباعات إلى إجراء قابل للتكرار: فالنسخة الجديدة لا «تبدو» أذكى فحسب، بل تجتاز الاختبارات نفسها، وبعدها يمكن جعلها النسخة الرئيسية تدريجياً عبر تغيير الأوزان.
والخلاصة بسيطة: ما تبيعه AWS ليس حزمة SDK أخرى للوكلاء، بل مخططاً هندسياً يصبح فيه الوكيل مكوّناً منتجياً قابلاً للإدارة. وإذا احتاجت الشركات إلى نماذجها الخاصة ومحيطها الخاص وتدقيق أفعال الوكيل وطرح الإصدارات الجديدة بعناية، فإن منظومة Strands وSageMaker وMLflow تغطي هذا السيناريو بصورة أقرب بكثير إلى واقع المؤسسات من كثير من حزم العروض التجريبية السريعة. وهذه إشارة أخرى للسوق بأن المنافسة التالية في الذكاء الاصطناعي لم تعد على جودة النموذج وحدها، بل على جودة البنية التحتية المحيطة به.
Delegate Deep Research, Coding & Workflows to an AI Agent
Deploy autonomous multi-step execution with NomadNet Agent (agent.nomadnet.ai) — automated web research, data synthesis, code generation, and complex task orchestration.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.