غوغل تعلّم الذكاء الاصطناعي التنبؤ بالفيضانات من تقارير الصحف القديمة
تستخدم غوغل التقارير الإخبارية القديمة ونموذجًا لغويًا كبيرًا (LLM) للتنبؤ بالفيضانات المفاجئة. تُحوَّل النصوص المؤرشفة إلى بيانات رقمية، وهو ما يعالج نقص القياسات الهيدرولوجية في الدول النامية. ويجري اختبار النموذج حاليًا في مناطق لا تتوافر فيها أجهزة استشعار ولا محطات أرصاد جوية.
معالج بواسطة الذكاء الاصطناعي من TechCrunch؛ بتحرير Hamidun News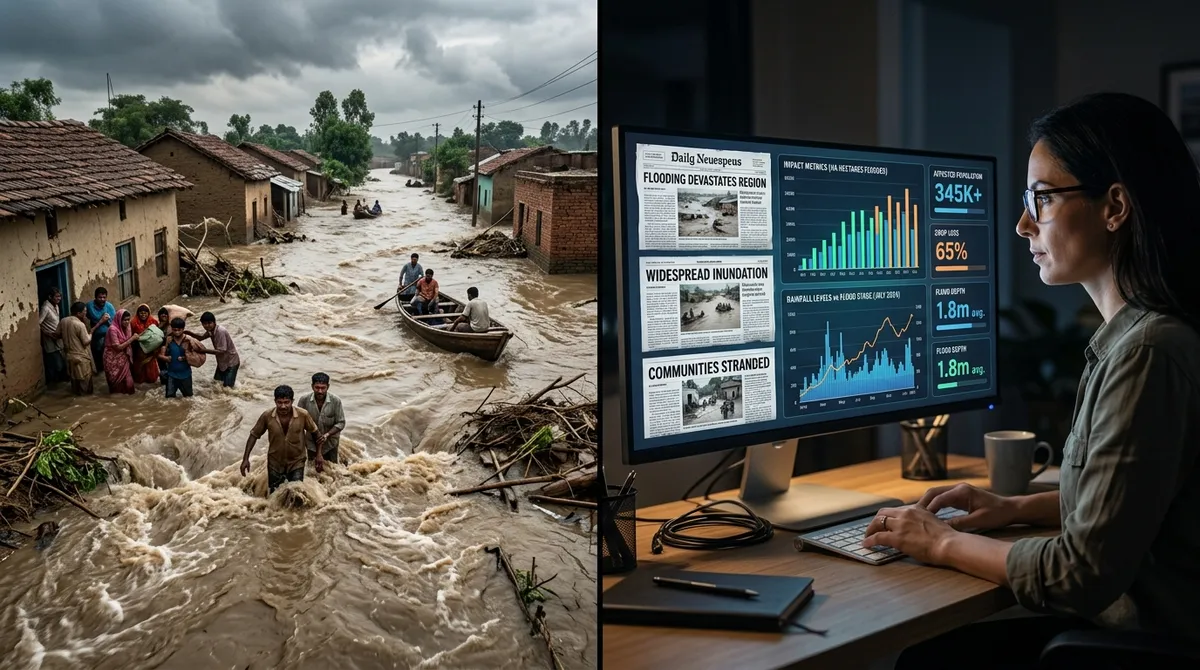
طوّرت غوغل نهجًا غير تقليدي للتنبؤ بالفيضانات المفاجئة: فبدلًا من الاعتماد على بنية تحتية باهظة التكلفة من أجهزة الاستشعار، تستخدم الشركة التقارير الإخبارية المؤرشفة مصدرًا للبيانات التاريخية. ويحوّل نموذج لغوي الأوصاف النصية النوعية للكوارث الطبيعية إلى مؤشرات كمية تصلح لتدريب النماذج الهيدرولوجية.
والمشكلة التي تعالجها هذه الطريقة معروفة جيدًا لدى علماء المناخ. فنماذج التنبؤ الدقيقة بالسيول تتطلب سلاسل بيانات تمتد سنوات طويلة عن منسوب المياه وهطول الأمطار والتضاريس. لكن هذه البنية التحتية ببساطة غير موجودة في معظم الدول النامية، حيث تكون الفيضانات الأشد فتكًا. فأجهزة الاستشعار تكلّف أموالًا وتحتاج إلى صيانة وكهرباء، وكل ذلك شحيح في المناطق الأكثر هشاشة.
ومع ذلك، توجد معلومات تاريخية عن الفيضانات في أرشيفات الصحف وتقارير الصحف المحلية والنشرات الحكومية. غير أن هذه البيانات نوعية: فعبارة «فيضان عنيف أغرق ثلاث قرى» ليست رقمًا يمكن لنموذج تقليدي أن يعمل به.
واقترحت غوغل استخدام نموذج لغوي كبير (LLM) بمثابة مترجم: يقرأ النموذج النص التاريخي ويستخرج منه تقديرات رقمية منظَّمة لحجم الحدث ومدته ونطاقه الجغرافي. ثم تُستخدم السلاسل الرقمية الاصطناعية الناتجة لتدريب نموذج التنبؤ بالفيضانات. وبذلك يصبح العمل الصحفي المؤرشف بديلًا عن عقود من القياسات الآلية.
وهذا أسلوب جديد جذريًا في التعامل مع نقص البيانات في المهام المناخية، ويمكن من حيث المبدأ تطبيقه خارج نطاق الهيدرولوجيا بكثير.
تختبر غوغل النظام حاليًا في مناطق من أفريقيا وجنوب آسيا، حيث تكاد تنعدم الإنذارات من السيول. وتطوّر الشركة مشروع Flood Hub منذ عام 2023، وهو يغطي اليوم أكثر من 80 دولة. ومن المفترض أن يوسّع الأسلوب الجديد نطاق التغطية ليشمل أراضي ظلّت خارج نطاق التنبؤ بسبب غياب البيانات الرقمية التاريخية.
وهذا مثال لافت على كيف تغيّر النماذج اللغوية الكبيرة بنية البيانات العلمية نفسها. ففي السابق، كان الحد الفاصل بين «البيانات متوافرة» و«البيانات غير متوافرة» تحدده معدات القياس. أما الآن فيمكن دفع هذا الحد إلى الأمام بفضل نماذج لغوية قادرة على استخراج معلومات كمية كامنة من نصوص كُتبت دون أي غاية علمية.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.