طلاب دراسات عليا من بيركلي يتحولون إلى الحَكَم الأول في صناعة الذكاء الاصطناعي: كيف تقرر Arena أي نموذج هو الأفضل
أنشأ طلاب دراسات عليا في جامعة كاليفورنيا في بيركلي منصة Arena، التي أصبحت عملياً التصنيف الرئيسي للنماذج اللغوية. وخلال سبعة أشهر فقط، انتقل المشروع من تجربة بحثية إلى شركة ناشئة تؤثر تقييماتها في جولات التمويل والحملات التسويقية لأكبر شركات الذكاء الاصطناعي. تعتمد Arena على التعهيد الجماعي: يقارن المستخدمون إجابتَي نموذجين مجهولين ويصوّتون للأفضل. ويجمع النظام ملايين المقارنات من هذا النوع ويحوّلها إلى تصنيف بطريقة إيلو، وهي الرياضيات نفسها التي تُقيَّم بها لاعبو الشطرنج. ومع ذلك، للنظام قيود واضحة، إذ يصوّت جمهور الإنترنت لا عيّنة تمثيلية من المهنيين، والمهام التي يطرحها المستخدمون لا تعكس دائماً سيناريوهات الإنتاج الفعلية. والسؤال المطروح هو ما إذا كانت هذه الحيادية ستبقى مع نمو الشركة الناشئة واستقطابها تمويلاً خارجياً.
معالج بواسطة الذكاء الاصطناعي من TechCrunch؛ بتحرير Hamidun News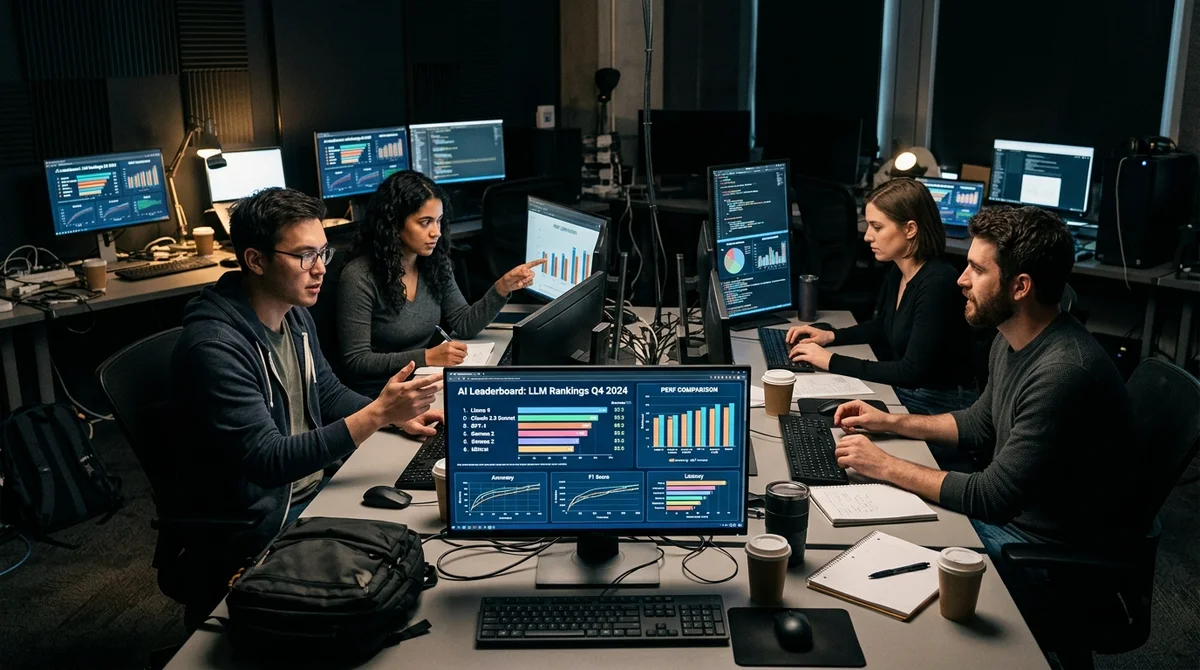
بينما تتنافس شركات الذكاء الاصطناعي على لقب أفضل نموذج، وجد حق إصدار الحكم نفسه بيد مجموعة من طلاب الدراسات العليا في جامعة كاليفورنيا في بيركلي. فقد أصبحت Arena، المعروفة سابقاً باسم LM Arena، لوحة الصدارة العلنية الرئيسية للنماذج الرائدة (frontier). وتُستشهد مراتبها في البيانات الصحفية، ويأخذها المستثمرون في رأس المال المخاطر في الحسبان، وتعتمد عليها فرق المطورين عند اختيار النموذج الأساسي. وخلال سبعة أشهر فقط، تحوّل المشروع من تجربة أكاديمية إلى شركة ناشئة متكاملة ذات تأثير حقيقي في الصناعة.
يقوم مبدأ عمل Arena على التعهيد الجماعي: يقارن المستخدمون إجابتَي نموذجين مجهولين ويصوّتون للأفضل. ويراكم النظام ملايين المقارنات من هذا النوع ويحوّلها إلى تصنيف بطريقة إيلو (Elo)، وهي الرياضيات نفسها التي تُقيَّم بها لاعبو الشطرنج. ويستبعد إخفاء هوية النماذج تحيّز العلامة التجارية: فالمستخدم لا يعرف لمن تعود الإجابة التي يقرؤها إلا بعد أن يصوّت.
وتؤثر البنية التي نمت من مشروع جامعي اليوم في أكبر اللاعبين في السوق. فحين تطلق OpenAI أو Google أو Anthropic نموذجاً جديداً، يصبح موقعه في Arena من أوائل مؤشرات النجاح. وتتابع صناديق رأس المال المخاطر هذا التصنيف عند اتخاذ قرارات الاستثمار، وتبني فرق التسويق حملاتها الإعلامية حول سطر في لوحة الصدارة.
ومع ذلك، للنظام قيود واضحة. فالتصويت يتم من جمهور الإنترنت، لا من عيّنة تمثيلية من المهنيين. والمهام التي يطرحها المستخدمون على النماذج لا تعكس دائماً سيناريوهات الإنتاج الفعلية. وأخيراً، فإن مستخدمي Arena النشطين هم في الغالب من المتحمسين المتمرسين تقنياً، لا من العميل المؤسسي المتوسط.
ورغم ذلك، ملأت Arena فراغاً عجزت المعايير الأكاديمية عن سدّه. فالاختبارات القياسية مثل MMLU أو HumanEval تقيس قدرات محدودة في ظروف خاضعة للتحكم. أما Arena فتقيس أصعب ما يمكن صياغته رسمياً: هل تعجب الناس هذه الإجابة. وهذا الانطباع هو ما يحدد في النهاية أي نموذج سيختاره المستخدم.
تُعدّ قصة Arena مثالاً دالاً على قدرة المجتمع الأكاديمي على وضع المعايير في صناعة سريعة التطور، لا تملك فيها الشركات الكبرى الوقت ولا الحافز لبناء بنية تقييم محايدة. والسؤال المطروح هو ما إذا كانت هذه الحيادية ستبقى مع نمو الشركة الناشئة واستقطابها تمويلاً خارجياً.
- 30 أكتوبر 2026Claude Enterprise يحصل على تقارير ذكية: من يستخدم الذكاء الاصطناعي وكيف وبكم
- 29 أكتوبر 2026TokenRouter يسرّع التوجيه على مستوى الرمز بين النماذج حتى 64 ضعفًا
- 29 أكتوبر 2026Google تفتح Android Studio أمام وكلاء ذكاء اصطناعي من جهات أخرى: Claude وCodex وأكثر من 40 وكيلًا آخر
- 29 أكتوبر 2026Claude Code يمنتج الفيديو انطلاقًا من التفريغ النصي: كيف يعمل video-use الحاصل على 30 000 نجمة
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.