OpenAI تطلق GPT-5.3-Codex-Spark على رقائق Cerebras بدلًا من Nvidia
خطت شركة OpenAI خطوة مهمة نحو الاستقلال في العتاد بإطلاقها نموذج GPT-5.3-Codex-Spark. وللمرة الأولى في تاريخ الشركة، جرى تدريب أحد منتجاتها الرائدة وتشغيله على رقائق Wafer Scale Engine 3 من شركة Cerebras Systems الناشئة، لا على وحدات معالجة الرسومات من Nvidia. ورقاقة WSE-3 عبارة عن شريحة ضخمة بحجم رقاقة سيليكون كاملة، وتتمتع بقدرة حوسبية هائلة. تهدف مبادرة OpenAI هذه إلى تنويع سلاسل التوريد وتقليل الاعتماد على مسرّعات Nvidia التي يشحّ المعروض منها. وقد يغيّر الانتقال إلى عتاد بديل اقتصاديات تدريب النماذج اللغوية الكبيرة تغييرًا كبيرًا، ويسرّع تطوير معماريات جديدة.
معالج بواسطة الذكاء الاصطناعي من 3DNews AI؛ بتحرير Hamidun News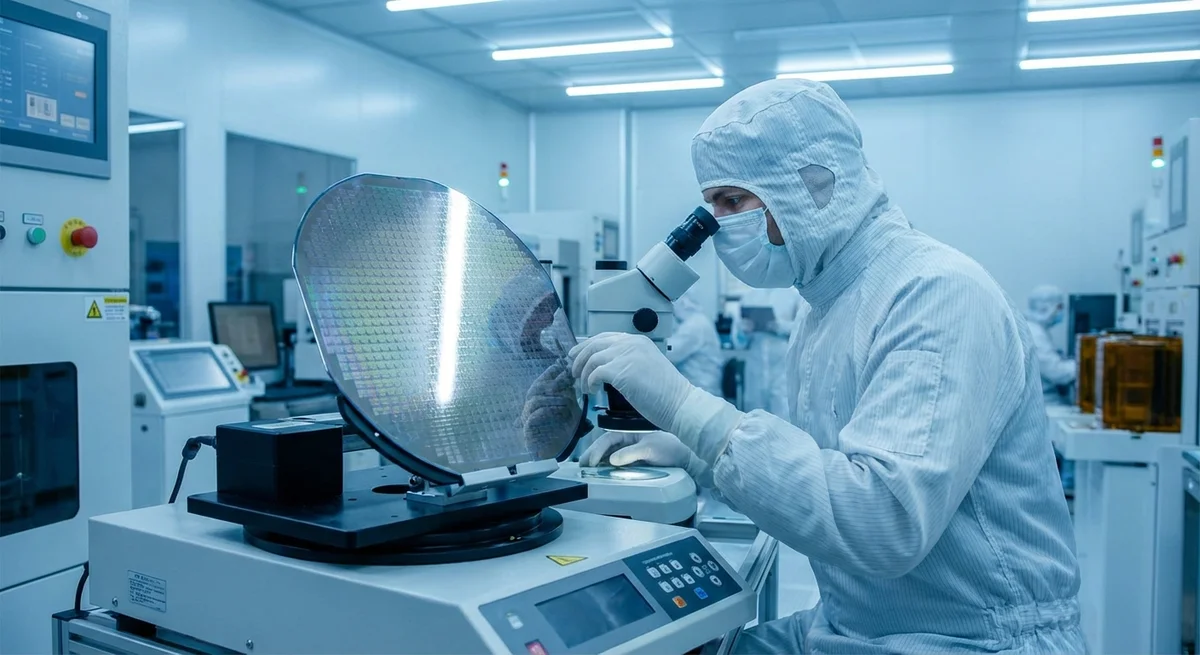
# OpenAI تتخلى عن Nvidia. ماذا يعني ذلك لمستقبل الذكاء الاصطناعي
شهد تاريخ النماذج اللغوية الكبيرة لحظة اعتبرها كثيرون مستحيلة. فقد أطلقت OpenAI نموذج GPT-5.3-Codex-Spark، وهو أول نموذج رائد للشركة يُدرَّب ويُنشَر على رقائق بديلة هي Wafer Scale Engine 3 من Cerebras Systems، لا على وحدات معالجة الرسومات من Nvidia. وهذه الخطوة ليست مجرد إنجاز تقني، بل نقطة تحوّل في اقتصاديات الذكاء الاصطناعي، وفي صراع أقوى شركات القطاع من أجل الاستقلال.
على مدى السنوات الخمس الماضية، فرضت Nvidia سيطرة شبه احتكارية على سوق مسرّعات تدريب الشبكات العصبية. فعندما اتضح أن معماريات transformer تتطلب قدرات حوسبية ضخمة، راهنت جميع المختبرات الكبرى، من OpenAI إلى Meta وGoogle، على وحدات GPU الخاصة بها. غير أن الاعتماد على مورّد واحد ينطوي على مخاطر. فقيود التصدير إلى الصين، ونقص الرقائق، وارتفاع الأسعار، كلها ضغطت على الشركات التي تحاول توسيع نماذجها. وقد عانت OpenAI بصمت مثل غيرها، لكنها قررت الآن التحرك.
قدمت Cerebras Systems نهجًا غير تقليدي. فبدلًا من إنتاج آلاف المعالجات الصغيرة، صمّمت الشركة WSE-3، وهي شريحة سيليكون أحادية الكتلة بحجم رقاقة كاملة، ولا يمكن تركيبها في مقبس عادي. وهي ليست مجرد رقاقة، بل مزرعة حوسبة مصغّرة على قطعة واحدة من السيليكون، وتضم أكثر من 900 ألف نواة. قد يبدو هذا الحل مخالفًا لمبدأ التصميم المعياري، لكنه بالتحديد ما مكّن Cerebras من تجنب اختناقات نقل البيانات بين المعالجات المنفصلة، وهي العدو الرئيسي للتدريب المتوازي.
وعندما اختبرت OpenAI تدريب GPT-5.3-Codex-Spark على WSE-3، جاءت النتائج غير متوقعة. فقد بقيت سرعة تقارب النموذج على مستوى التدريب على Nvidia H100، لكن الحاجة إلى المزامنة ونقل البيانات بين المسرّعات قلّت. وبعبارة أخرى، يمكن الآن استخدام ساعات الخمول الشبكي التي كانت الشركة تهدرها سابقًا في حوسبة مفيدة. وهذا يعني كلفة أقل، وسرعة أعلى.
لكن الأهم ليس الأرقام التقنية، بل المغزى الاستراتيجي. فقد أظهرت OpenAI أن بديلًا لـ Nvidia موجود، وأن النماذج الكبيرة يمكن تدريبها على غير رقائقها. وهذا أول تحدٍّ جدّي للاحتكار، والسوق تتفاعل معه بالفعل. فالشركات الأخرى، ومنها Intel بمسرّعات Gaudi، وAMD بمعالجات EPYC وMI300، وحتى Google بوحدات TPU، تعلم الآن أن هناك نافذة فرصة. فإذا استطاعت OpenAI إعادة تدريب نموذج على عتاد جديد وتحقيق نتائج مماثلة، فبوسعها هي أيضًا أن تفعل ذلك.
ستتغير اقتصاديات الذكاء الاصطناعي، لكن ليس فورًا. فحتى الآن لا تستطيع Cerebras إنتاج WSE-3 بالكميات التي تنتج بها Nvidia رقائق H100. كما أن إعادة بناء البنية التحتية وإعادة كتابة الشيفرة لتناسب المعمارية الجديدة سيتطلبان وقتًا. ومع ذلك، فقد وُضعت البداية. ومن المرجح أن نشهد خلال العامين أو الثلاثة المقبلة تصاميم أكثر جرأة للمسرّعات، وتجارب أوسع مع الرقائق العصبية المحاكية (neuromorphic) والحواسيب الكمومية. وستبقى Nvidia لاعبًا قويًا، لكنها لن تكون الوحيدة.
أما بالنسبة لمستخدمي ChatGPT العاديين، فلن يتغير شيء تقريبًا؛ فالنموذج هو نفسه، وقدراته كما كانت. لكن الفارق بالنسبة للقطاع هائل. فقد أثبتت OpenAI أن الذكاء الكبير يمكن بناؤه بطريقة مختلفة، وأن سباق العتاد لا يفوز به من وصل أولًا، بل من يفكر أسرع.
*Meta مصنفة منظمة متطرفة ومحظورة في روسيا.
- 30 أكتوبر 2026Claude Enterprise يحصل على تقارير ذكية: من يستخدم الذكاء الاصطناعي وكيف وبكم
- 29 أكتوبر 2026TokenRouter يسرّع التوجيه على مستوى الرمز بين النماذج حتى 64 ضعفًا
- 29 أكتوبر 2026Google تفتح Android Studio أمام وكلاء ذكاء اصطناعي من جهات أخرى: Claude وCodex وأكثر من 40 وكيلًا آخر
- 29 أكتوبر 2026Claude Code يمنتج الفيديو انطلاقًا من التفريغ النصي: كيف يعمل video-use الحاصل على 30 000 نجمة
Build & Ship Production AI Agents Without Boilerplate Code
Start your free 72-hour trial at Hamidun Academy (academy.hamidun.com) — interactive lessons on Claude Code & Cursor, live Tech Radar, and production agent templates.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.