PostgreSQL في OpenAI: كيف تُوسَّع قاعدة البيانات الداعمة لـ ChatGPT
شاركت OpenAI تجربتها في توسيع PostgreSQL لدعم ChatGPT. واعتمدت على النسخ المتماثل والتخزين المؤقت وتحديد معدل الطلبات وعزل أحمال العمل للوصول إلى ملايين الاستعلامات في الثانية. نستعرض فيما يلي بنية النظام والقرارات الهندسية التي اتُّخذت.
معالج بواسطة الذكاء الاصطناعي من OpenAI Blog؛ بتحرير Hamidun News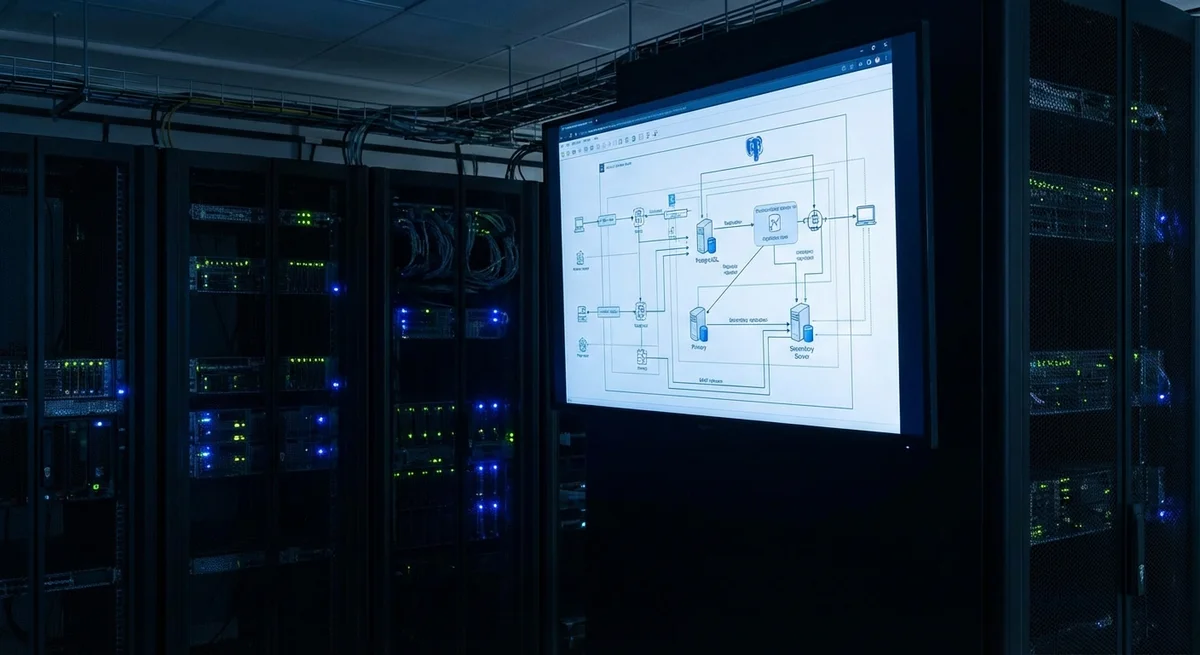
عندما قفز ChatGPT إلى مستويات غير مسبوقة من الانتشار، واجه فريق OpenAI تحديًا جديًا: كيف يضمن عملًا مستقرًا وسريعًا لقاعدة البيانات التي يقوم عليها كل شيء، وهي PostgreSQL. فالمطلوب كان دعم مئات الملايين من المستخدمين ومعالجة ملايين الاستعلامات في الثانية. ولم يتطلب حل هذه المهمة مجرد زيادة في العتاد، بل إعادة تفكير عميقة في البنية المعمارية وتطبيق مجموعة من الحيل الهندسية.
ورغم نضج PostgreSQL وموثوقيتها، فإنها لم تُصمَّم في الأصل لتحمّل أحمال بهذه الضخامة. فالأساليب التقليدية للتوسيع، مثل التوسيع العمودي (أي رفع قدرة خادم واحد)، بلغت سقفها سريعًا. وبات واضحًا أن الحل يكمن في نهج أفقي يوزّع الحمل على عدد كبير من الخوادم. واختارت OpenAI مسار النسخ المتماثل (replication)، فأنشأت نسخًا عديدة من قاعدة البيانات مخصصة للقراءة فقط. وقد خفّف ذلك الضغط عن الخادم الرئيسي بدرجة كبيرة ورفع الإنتاجية الإجمالية.
غير أن النسخ المتماثل ليس سوى جزء من الحل. فللمضي في التحسين، استُخدم التخزين المؤقت (caching)، أي حفظ البيانات الأكثر طلبًا في الذاكرة العشوائية، ما أتاح تجنّب الرجوع إلى قاعدة البيانات مع كل استعلام. كما جرى اعتماد نظام لتحديد معدل الطلبات (rate limiting) يمنع تحميل النظام فوق طاقته عند القفزات المفاجئة في حركة البيانات. وأخيرًا، أدّى عزل أحمال العمل دورًا مهمًا، إذ وُزّعت أنواع الاستعلامات المختلفة على خوادم منفصلة لتفادي التعارض وإعطاء الأولوية للعمليات الأكثر أهمية.
وبفضل هذه الأساليب، لم تتمكن OpenAI من استيعاب الحمل الحالي فحسب، بل بنت أيضًا بنية قابلة للتوسع وجاهزة لمزيد من النمو. وهذه سابقة مهمة للقطاع بأسره، إذ تُظهر أن التقنيات الناضجة مثل PostgreSQL يمكن توظيفها بنجاح لدعم أكثر تطبيقات الذكاء الاصطناعي تطلبًا. وتبيّن تجربة OpenAI أهمية النهج المتكامل الذي يجمع بين النسخ المتماثل والتخزين المؤقت وتحديد معدل الطلبات وعزل أحمال العمل.
وتتجاوز انعكاسات هذه التجربة حدود OpenAI بكثير. فبإمكان شركات أخرى تتعامل مع البيانات الضخمة والأحمال العالية الاستفادة من هذه الخلاصات في تحسين أنظمتها. ويصدق ذلك خصوصًا على منصات التجارة الإلكترونية وشبكات التواصل الاجتماعي وسائر الخدمات التي تحتاج إلى وصول فوري إلى كميات كبيرة من المعلومات. كما قد تحفّز هذه التجربة مزيدًا من التطوير في PostgreSQL وقواعد البيانات الأخرى، بما يحسّن قابليتها للتوسع وأداءها.
وفي الختام، فإن نجاح OpenAI في توسيع PostgreSQL ليس مجرد إنجاز تقني، بل درس مهم للقطاع بأكمله. فهو يُظهر أن النهج السليم في تصميم البنية والتحسين قد يمكّن حتى التقنيات الناضجة من التعامل مع أصعب المهام. ويفتح ذلك آفاقًا جديدة لتطوير الذكاء الاصطناعي ومجالات أخرى تتطلب معالجة البيانات الضخمة.
- 31 أكتوبر 2026مؤلف يعرض سيناريو على محكمة محلّفين من الذكاء الاصطناعي: الحكم كلّف 850 ألف توكن
- 31 أكتوبر 2026Anthropic: دمج الوكلاء الفرعيين في حلقة واحدة سرّع المهام لدى أحد العملاء إلى الضعف
- 30 أكتوبر 2026Claude Enterprise يحصل على تقارير ذكية: من يستخدم الذكاء الاصطناعي وكيف وبكم
- 29 أكتوبر 2026TokenRouter يسرّع التوجيه على مستوى الرمز بين النماذج حتى 64 ضعفًا
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.