تجميع النصوص دون وسم: تضمينات LLM وخوارزمية HDBSCAN من Machine Learning Mastery
لا تقتصر قدرات نماذج اللغة على الإجابة في المحادثات، فهي تحوّل النص إلى متجهات رقمية يمكن عبرها اكتشاف المجموعات الموضوعية تلقائيًا. ينشر Machine Learning Mastery دليلًا يشرح كيفية الجمع بين تضمينات LLM وخوارزمية HDBSCAN لتجميع آلاف المستندات دون وسم. يتألف خط المعالجة من الخطوات التالية: التضمين ← UMAP (خفض الأبعاد) ← HDBSCAN ← تسميات تلقائية للموضوعات.
معالج بواسطة الذكاء الاصطناعي من Machine Learning Mastery؛ بتحرير Hamidun News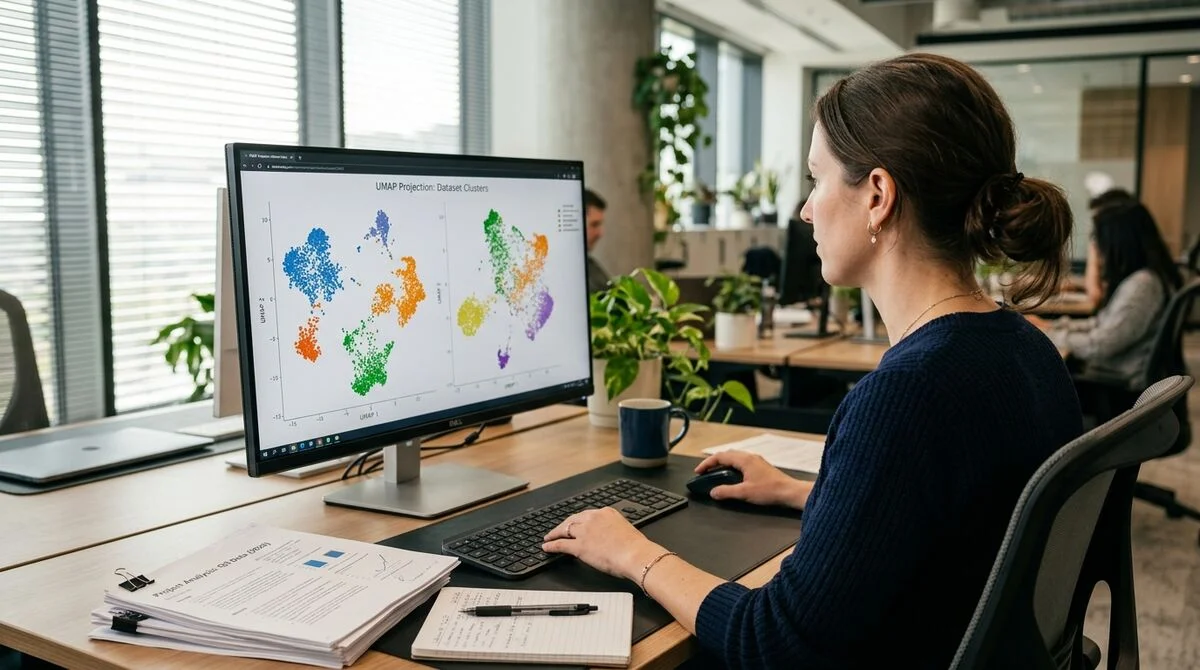
أخرجت تضمينات LLM المهام المتعلقة بالنصوص غير المهيكلة إلى ما هو أبعد بكثير من واجهات المحادثة. ينشر Machine Learning Mastery دليلًا عمليًا يشرح كيفية الجمع بين التمثيلات المتجهية لنماذج اللغة وخوارزمية HDBSCAN، لاكتشاف المجموعات الموضوعية تلقائيًا في مجموعات النصوص الكبيرة، دون وسم يدوي ودون معرفة مسبقة ببنية البيانات.
لماذا تغيّر التضمينات قواعد اللعبة
تستطيع نماذج اللغة تحويل النص إلى متجهات عالية الأبعاد. هذه تمثيلات رقمية تقع فيها المقاطع المتقاربة دلاليًا قريبةً من بعضها هندسيًا. فعبارتا «العميل غير راضٍ عن السعر» و«الأمر مكلف جدًا بالنسبة لي» ستكونان جارتين في الفضاء متعدد الأبعاد، بينما تقع عبارة «مشكلة في التوصيل» في جزء مختلف تمامًا منه. وهذا بالضبط ما يجعل التضمينات مدخلًا مثاليًا للتجميع: فالنظام يراعي المعنى لا تطابق الكلمات المفتاحية. ولم تعد هناك حاجة إلى قواميس المرادفات ولا إلى القواعد اليدوية.
من النماذج الشائعة للحصول على التضمينات: text-embedding-3-small من OpenAI، وCohere Embed v3، إضافةً إلى مكتبة sentence-transformers مفتوحة المصدر التي تعمل محليًا دون تكاليف API. يبلغ بُعد التضمين النموذجي 768–3072، وهو كبير جدًا للتجميع المباشر. ومن المعتاد تطبيق UMAP قبل HDBSCAN لضغط الفضاء إلى 5–50 بُعدًا. وبدون هذه الخطوة تصطدم الخوارزمية بـ«لعنة الأبعاد»: ففي الفضاء عالي الأبعاد تبدو جميع النقاط متباعدة بالقدر نفسه تقريبًا، فلا تتشكل مجموعات.
HDBSCAN مقابل الطرق القياسية
تبدأ معظم دورات التجميع بخوارزمية K-means. والمشكلة أنها تتطلب تحديد عدد المجموعات مسبقًا، وهو أمر غير ممكن حين تكون بنية البيانات مجهولة. أما HDBSCAN (التجميع الهرمي المكاني القائم على الكثافة للتطبيقات ذات الضوضاء — Hierarchical Density-Based Spatial Clustering of Applications with Noise) فيعالج المسألة بطريقة مختلفة:
- لا يتطلب تحديد عدد المجموعات مسبقًا
- يضع علامة «ضوضاء» تلقائيًا على النقاط التي لا تنتمي إلى أي مجموعة، أي النصوص التي لا تتلاءم مع أي فئة
- يتعامل بشكل صحيح مع مجموعات تختلف في الحجم والكثافة
- يتوسع ليشمل عشرات الآلاف من المستندات
- يوفّر تسلسلًا هرميًا للمجموعات مع تحكم في مستوى التفصيل
خط المعالجة الكامل: التضمينات ← خفض الأبعاد عبر UMAP ← HDBSCAN ← تسميات المجموعات. ويستغرق الكود بأكمله بضعة عشرات من أسطر Python باستخدام مكتبات sentence-transformers وumap-learn وhdbscan. ولتفسير الموضوعات المكتشفة يكفي تمرير بضعة أمثلة من كل مجموعة إلى LLM وطلب اقتراح اسم لها، فتُغلق الحلقة من نموذج اللغة إلى الإحصاء ثم تعود إليه.
التطبيق دون مجموعة تدريب
الميزة الرئيسية لهذه التركيبة هي انعدام الحاجة إلى الوسم. فلا حاجة للاتفاق على الفئات، ولا لتعيين مقيّمين، ولا لتكوين مجموعة تدريب. خط معالجة واحد يكتشف البنية بنفسه.
«يتركز عصر الذكاء الاصطناعي التوليدي الحالي على واجهات المحادثة، لكن إمكانات نماذج اللغة تتجاوز ذلك بكثير»، يكتب مؤلفو
Machine Learning Mastery.
من السيناريوهات النموذجية: تجميع آلاف طلبات الدعم، والتصنيف التلقائي لتدفقات الأخبار، وتجميع تقييمات المنتجات، وتحليل الأسئلة المفتوحة في الاستبيانات، واكتشاف الأنماط الشاذة في السجلات. تظهر النتيجة خلال دقائق، دون وسم مسبق.
وتزداد قيمة هذا النهج عند التعامل مع بيانات سريعة التغير: إذ تُكتشف الموضوعات الجديدة تلقائيًا، ولا حاجة لإضافة فئات إلى المصنِّف يدويًا عند كل تغيّر في المجال.
ماذا يعني ذلك
تمثل هذه التركيبة بين تضمينات LLM وHDBSCAN أداة جاهزة لهيكلة مجموعات البيانات النصية الكبيرة دون إشراف (supervision). فالمهام التي كانت تتطلب أسابيع من العمل اليدوي أو وسمًا مكلفًا باتت تُحل بسكربت صغير. وبالنسبة للفرق التي تعمل مع ملاحظات المستخدمين أو رصد وسائل الإعلام أو تحليلات المحتوى، فهذا توفير مباشر للموارد، وفرصة لاستخلاص رؤى من بيانات كانت تُترك سابقًا دون استفادة.
- 19 نوفمبر 2026OpenAI تكشف كيف يقيّد صندوق الرمل في Codex أوامر الوكيل على جهازك
- 19 نوفمبر 2026كلمة «لعبة فيديو» ترفع استعداد GPT-6 Astra لاختيار الأهداف من 6% إلى 92%
- 19 نوفمبر 2026ذكاء OpenAI الاصطناعي يحسّن تصميم GPU من AMD بما يصل إلى 14% في الطاقة والسرعة والمساحة خلال 5 أشهر
- 19 نوفمبر 2026وكلاء OpenAI ينجزون بمفردهم 46% من المهام البحثية التي تستغرق 2–4 ساعات، مقابل 23% سابقًا
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول لماذا تغيّر التضمينات قواعد اللعبة؟
تستطيع نماذج اللغة تحويل النص إلى متجهات عالية الأبعاد. هذه تمثيلات رقمية تقع فيها المقاطع المتقاربة دلاليًا قريبةً من بعضها هندسيًا. فعبارتا «العميل غير راضٍ عن السعر» و«الأمر مكلف جدًا بالنسبة لي» ستكونان جارتين في الفضاء متعدد الأبعاد، بينما تقع عبارة «مشكلة في التوصيل» في جزء مختلف تمامًا منه. وهذا بالضبط ما يجعل التضمينات مدخلًا مثاليًا للتجميع: فالنظام يراعي المعنى لا تطابق الكلمات المفتاحية. ولم تعد هناك حاجة إلى قواميس المرادفات ولا إلى القواعد اليدوية.
ما أبرز التفاصيل حول HDBSCAN مقابل الطرق القياسية؟
تبدأ معظم دورات التجميع بخوارزمية K-means. والمشكلة أنها تتطلب تحديد عدد المجموعات مسبقًا، وهو أمر غير ممكن حين تكون بنية البيانات مجهولة. أما HDBSCAN (التجميع الهرمي المكاني القائم على الكثافة للتطبيقات ذات الضوضاء — Hierarchical Density-Based Spatial Clustering of Applications with Noise) فيعالج المسألة بطريقة مختلفة: لا يتطلب تحديد عدد المجموعات مسبقًا يضع علامة «ضوضاء» تلقائيًا على النقاط التي لا تنتمي إلى أي مجموعة، أي النصوص التي لا تتلاءم مع أي فئة يتعامل بشكل صحيح مع مجموعات تختلف في…
ما أبرز التفاصيل حول التطبيق دون مجموعة تدريب؟
الميزة الرئيسية لهذه التركيبة هي انعدام الحاجة إلى الوسم. فلا حاجة للاتفاق على الفئات، ولا لتعيين مقيّمين، ولا لتكوين مجموعة تدريب. خط معالجة واحد يكتشف البنية بنفسه. «يتركز عصر الذكاء الاصطناعي التوليدي الحالي على واجهات المحادثة، لكن إمكانات نماذج اللغة تتجاوز ذلك بكثير»، يكتب مؤلفو Machine Learning Mastery. من السيناريوهات النموذجية: تجميع آلاف طلبات الدعم، والتصنيف التلقائي لتدفقات الأخبار، وتجميع تقييمات المنتجات، وتحليل الأسئلة المفتوحة في الاستبيانات، واكتشاف الأنماط الشاذة في السجلات.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.