مختبرات الذكاء الاصطناعي تدفع لشركة XDOF لجمع بيانات تدريب الروبوتات — عمل روتيني شاق
كي تتعلم الروبوتات الحركة والتعامل مع الأشياء، تحتاج إلى ملايين الساعات من العروض العملية الحقيقية، تمامًا كما تعلمت نماذج LLM من الإنترنت. وجمع هذه البيانات عمل رتيب وشاق: يقضي أشخاص ساعات في تشغيل الروبوتات يدويًا أو يتحركون مرتدين بدلات التقاط الحركة. وتدفع مختبرات الذكاء الاصطناعي بالفعل لشركات مثل XDOF لتحميلها هذا العمل عبر التعهيد الخارجي.
معالج بواسطة الذكاء الاصطناعي من TechCrunch؛ بتحرير Hamidun News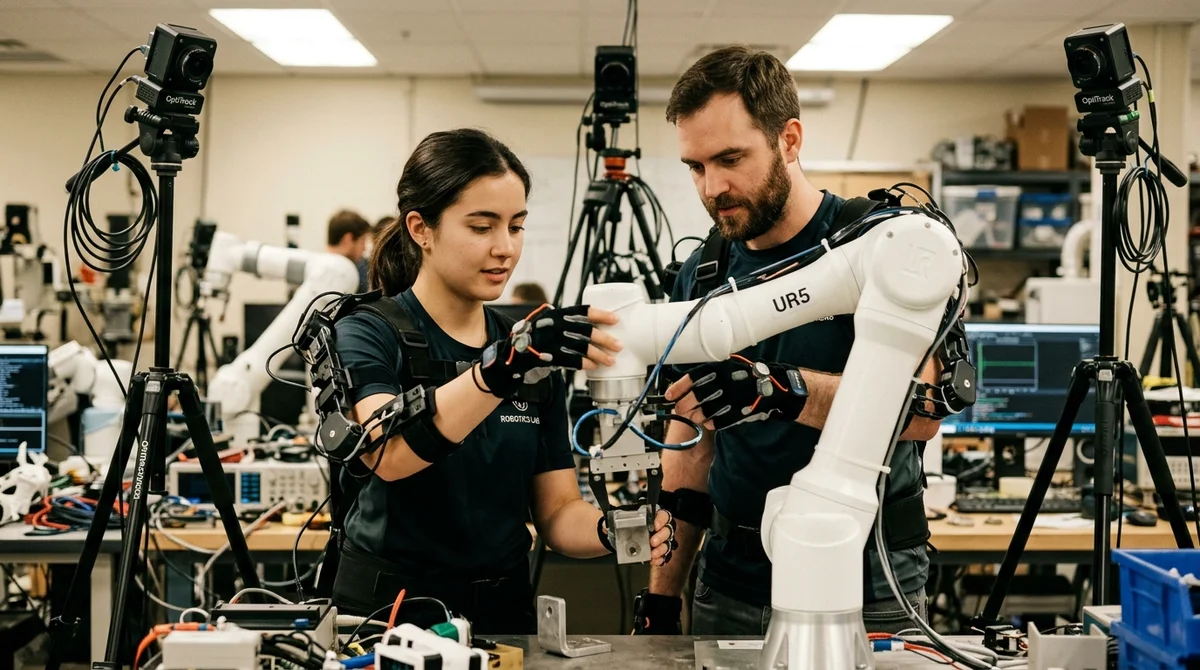
يواجه الذكاء الاصطناعي المادي المشكلة ذاتها التي كانت ستوقف النماذج اللغوية لولا الإنترنت الذي راكمته البشرية: نقص بيانات التدريب. وفي الوقت الحالي تحل المختبرات هذه المشكلة يدويًا، وتدفع مبالغ حقيقية لشركات مثل XDOF مقابل ذلك.
لماذا لا تكفي البيانات
تعلمت النماذج اللغوية الكبيرة «التفكير» من تريليونات الكلمات التي جمعتها البشرية على الشبكة. أما الروبوتات المادية فلا تملك رصيدًا كهذا: فالحركات والإمساك بالأشياء والحفاظ على التوازن والتعامل مع الأغراض الهشة، كلها يجب عرضها عمليًا ومباشرةً، مرة بعد مرة، في عشرات السيناريوهات المختلفة.
وتتطلب ساعة واحدة من العروض عالية الجودة جهدًا كبيرًا: يرتدي المشغّل هيكلًا خارجيًا (إكسوسكيليتون) أو يتحكم بالروبوت عبر عصا تحكم، فينفذ الحركة نفسها مئات المرات في إضاءة مختلفة ومع أجسام مختلفة وبأوضاع مختلفة. وتأتي البيانات مكلفة وبطيئة ومرتبطة ارتباطًا وثيقًا بالمكان المادي. ولن يفيد الإنترنت هنا.
ولهذا السبب بالذات واجهت الفرق الرائدة في مجال الذكاء الاصطناعي المادي، من Physical Intelligence إلى المختبرات داخل Google DeepMind ومطوّري الروبوتات البشرية، عقبة واحدة: يمكن تحسين النماذج إلى ما لا نهاية، لكنها لن تتدرب من دون حجم كافٍ من العروض عالية الجودة.
ماذا تفعل XDOF
XDOF إحدى الشركات التي تستعين بها مختبرات الذكاء الاصطناعي لتعهيد هذا العمل. فهي تدير العملية بأكملها: تجنّد المشغّلين، وتهيّئ المعدات، وتراقب جودة الوسم، وتوسّع الإنتاج وفق احتياجات كل عميل.
ويذكّر هذا النموذج ببدايات Scale AI التي وظّفت جيشًا من المُعلِّقين لوسم النصوص والصور. الفرق الوحيد أن الحديث هنا يدور عن عمل جسدي في فضاء حقيقي.
تبدو جلسة جمع البيانات النموذجية على النحو التالي:
- يتحكم المشغّل بالروبوت يدويًا، ويلتقط النظام مسارات الحركة وبيانات القوة
- ترصد عدة كاميرات المشهد في وقت واحد من زوايا مختلفة
- يُوسَم كل تكرار: نجاح، أو فشل، أو حالة حدّية
- يُعاد السيناريو في إضاءة مختلفة ومع أجسام مختلفة وبأوضاع مختلفة
- يستبعد الفحص النهائي العروض المعيبة
لا يتطلب هذا العمل تعليمًا هندسيًا، لكنه يتطلب الانتباه والصبر والتحمل البدني، وهو بالضبط «العمل الشاق وغير الجذاب» الذي يحذّر منه العاملون في القطاع.
من يدفع ولماذا يهم ذلك
يصطدم توسيع جمع البيانات بحدود الفيزياء: فلا يمكن تنزيل ملايين الحركات الروبوتية من الشبكة، ولا يمكن استبدالها ببيانات اصطناعية من دون خطر تدهور النموذج. ويتيح التعهيد الخارجي للمختبرات التركيز على البنية المعمارية والتدريب، بينما يتولى المتخصصون العمل الروتيني.
وينشأ مع ذلك نوع جديد من «العمل الخفي» في صناعة الذكاء الاصطناعي، لا يراه الجمهور العام لكنه بالغ الأهمية. وعلى غرار إشراف المحتوى (Content moderation) لنماذج LLM، سينمو سوق جمع العروض الروبوتية بسرعة، وبالسرعة نفسها سيجد نفسه في صلب النقاش حول ظروف العمل ومعايير الجودة.
ماذا يعني ذلك
ستحتاج حقبة الذكاء الاصطناعي المادي إلى بنية تحتية لجمع البيانات مماثلة لتلك التي وفّرها الإنترنت للنماذج اللغوية. وستحصل الشركات التي تبني أولًا خطوط إنتاج فعّالة لجمع العروض المادية ووسمها على ميزة هيكلية، بصرف النظر عن الجهة التي تطوّر النماذج نفسها.
- 24 أكتوبر 2026Google تفتح مصدر TorchTPU: PyTorch يحصل على TPU كجهاز أصيل
- 24 أكتوبر 2026مؤشر Harvey LAB-AA v1.1: نموذج Grok 4.7 يتصدر بنسبة 9.4% بعد إخضاعه لتدقيق الهلوسة
- 24 أكتوبر 2026Meta تطلق Muse Wonder وWonder Full: مؤشر الذكاء يرتفع من 48 إلى 56
- 24 أكتوبر 2026Moonshot AI تكشف عن Kimi K3.1 Pro، أول إصدار Pro بعد اختبار Kibitz
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول لماذا لا تكفي البيانات؟
تعلمت النماذج اللغوية الكبيرة «التفكير» من تريليونات الكلمات التي جمعتها البشرية على الشبكة. أما الروبوتات المادية فلا تملك رصيدًا كهذا: فالحركات والإمساك بالأشياء والحفاظ على التوازن والتعامل مع الأغراض الهشة، كلها يجب عرضها عمليًا ومباشرةً، مرة بعد مرة، في عشرات السيناريوهات المختلفة. وتتطلب ساعة واحدة من العروض عالية الجودة جهدًا كبيرًا: يرتدي المشغّل هيكلًا خارجيًا (إكسوسكيليتون) أو يتحكم بالروبوت عبر عصا تحكم، فينفذ الحركة نفسها مئات المرات في إضاءة مختلفة ومع أجسام مختلفة وبأوضاع مختلفة. وتأتي البيانات مكلفة وبطيئة ومرتبطة ارتباطًا وثيقًا بالمكان المادي. ولن يفيد الإن
ما أبرز التفاصيل حول ماذا تفعل XDOF؟
XDOF إحدى الشركات التي تستعين بها مختبرات الذكاء الاصطناعي لتعهيد هذا العمل. فهي تدير العملية بأكملها: تجنّد المشغّلين، وتهيّئ المعدات، وتراقب جودة الوسم، وتوسّع الإنتاج وفق احتياجات كل عميل. ويذكّر هذا النموذج ببدايات Scale AI التي وظّفت جيشًا من المُعلِّقين لوسم النصوص والصور. الفرق الوحيد أن الحديث هنا يدور عن عمل جسدي في فضاء حقيقي. تبدو جلسة جمع البيانات النموذجية على النحو التالي: يتحكم المشغّل بالروبوت يدويًا، ويلتقط النظام مسارات الحركة وبيانات القوة ترصد عدة كاميرات المشهد في وقت واحد من زوايا مختلفة يُوسَم كل تكرار: نجاح، أو فشل، أو حالة حدّية يُعاد السيناريو في إ
ما أبرز التفاصيل حول من يدفع ولماذا يهم ذلك؟
يصطدم توسيع جمع البيانات بحدود الفيزياء: فلا يمكن تنزيل ملايين الحركات الروبوتية من الشبكة، ولا يمكن استبدالها ببيانات اصطناعية من دون خطر تدهور النموذج. ويتيح التعهيد الخارجي للمختبرات التركيز على البنية المعمارية والتدريب، بينما يتولى المتخصصون العمل الروتيني. وينشأ مع ذلك نوع جديد من «العمل الخفي» في صناعة الذكاء الاصطناعي، لا يراه الجمهور العام لكنه بالغ الأهمية. وعلى غرار إشراف المحتوى (Content moderation) لنماذج LLM، سينمو سوق جمع العروض الروبوتية بسرعة، وبالسرعة نفسها سيجد نفسه في صلب النقاش حول ظروف العمل ومعايير الجودة.
Access Frontier LLMs & Multimodal AI in One Workspace
Discover NomadNet AI (nomadnet.ai) — unified access to frontier language models, research synthesis, and multimodal workflows.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.