نموذج لغوي أذربيجاني على SageMaker: كيف حلّت Azercell مشكلة اللغة النادرة
طوّرت Azercell، مشغّل الاتصالات الأذربيجاني، نموذجًا لغويًا كبيرًا خاصًا بها باستخدام Amazon SageMaker AI. وخلال ستة أسابيع من العمل المكثف مع AWS Generative AI Innovation Center، تغلبت الشركة بنجاح على النقص المزمن في بيانات التدريب وعلى التعقيد الصرفي للغة الأذربيجانية. نتج عن ذلك نموذج LLM جاهز للإنتاج (production-ready) لروبوت دردشة موجّه إلى العملاء (customer-facing) ولعمليات الأعمال الداخلية، وهو أول مثال صناعي من نوعه في المنطقة.
معالج بواسطة الذكاء الاصطناعي من AWS Machine Learning Blog؛ بتحرير Hamidun News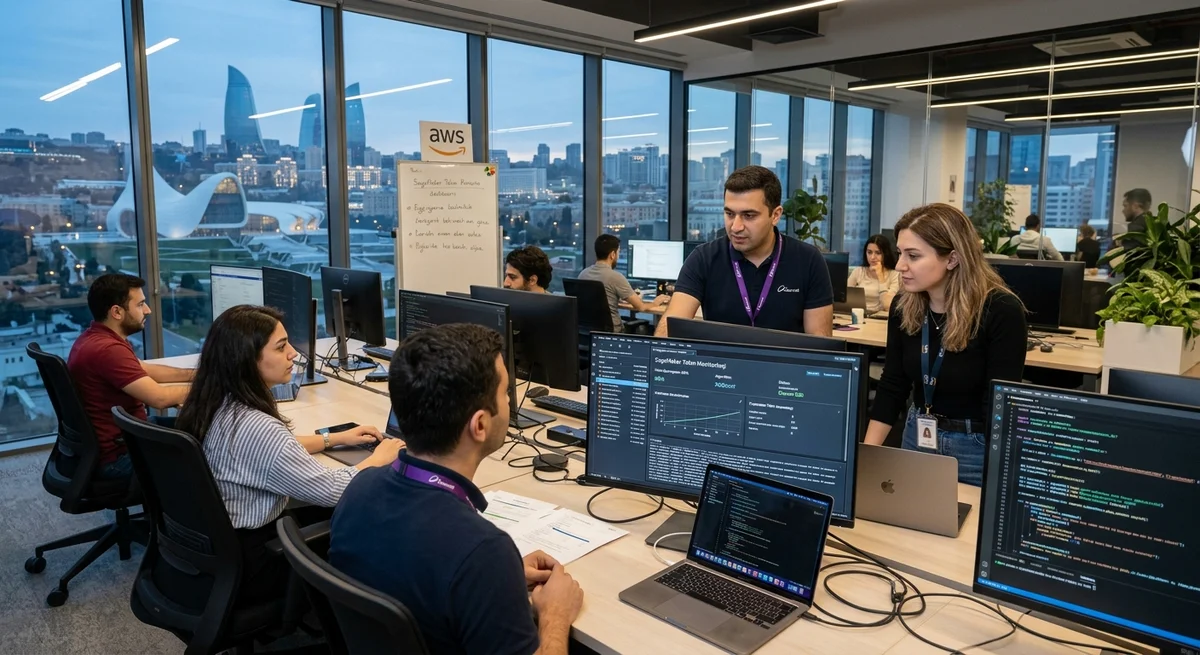
طوّرت Azercell، مشغّل الاتصالات الأذربيجاني، نموذجها اللغوي الخاص على Amazon SageMaker AI. وضعت الشركة أمامها مهمة طموحة: بناء نموذج LLM بمستوى الإنتاج (production-grade) للغة معقّدة صرفيًا، تعاني نقصًا في البيانات الجاهزة، ولا توجد لها حلول قائمة في السوق.
لماذا تُعدّ أذربيجان حالة صعبة
اللغة الأذربيجانية مثال نموذجي على اللغات الإلصاقية ذات الصرف الغني. فالكلمة الواحدة قد تحمل عددًا كبيرًا من اللواحق التي تغيّر معناها ووظيفتها النحوية جذريًا. وهذا يستلزم مقاربات مختلفة تمامًا في تقسيم النص إلى رموز (tokenization) وفي تدريب النماذج، مقارنةً باللغات الهندو-أوروبية.
ويُضاف إلى التعقيد الصرفي عامل حاسم: حجم بيانات التدريب المفتوحة المتاحة بالأذربيجانية أقل بكثير مما هو متاح للإنجليزية أو الروسية أو الإسبانية. ولا تنجح هنا مباشرةً الأساليب القياسية لتدريب LLM التي أثبتت فاعليتها على المدونات النصية الضخمة.
- يتطلب التعقيد الصرفي تقسيمًا خاصًا للنص إلى رموز
- شحّ البيانات: نصوص أقل بأكثر من 100 مرة مقارنةً باللغات الكبرى
- غياب أمثلة جاهزة وأفضل الممارسات (best practices) لنماذج LLM بالأذربيجانية
- الحاجة إلى تكييف نماذج الأساس (foundation models) المدرَّبة على بيانات إنجليزية
- ضرورة دمج النموذج في أنظمة الإنتاج لدى شركة الاتصالات
كيف حلّت Azercell المهمة
أبرمت الشركة شراكة مع AWS Generative AI Innovation Center. وخلال ستة أسابيع مكثفة من العمل المشترك، بنى مختصون من الجانبين إطار عمل جاهزًا للإنتاج على Amazon SageMaker.
شمل الحل عدة مكونات أساسية: إعداد البيانات المتوفرة وتنظيفها على النحو الصحيح، وتقسيمًا متخصصًا للنص إلى رموز يراعي صرف اللغة الأذربيجانية، وتحسين عملية التدريب بحيث تعمل بحجم بيانات أقل. واستخدم المهندسون التعلّم بالنقل (transfer learning)، أي تكييف نماذج مدرَّبة مسبقًا بدلًا من التدريب من الصفر على مدونة نصية أذربيجانية.
ما النتيجة: دوران للنموذج
يعمل نموذج Azercell في اتجاهين. الأول روبوت دردشة موجّه إلى العملاء (customer-facing) يساعد المشتركين في الاستفسار عن الخدمات والباقات باللغة الأذربيجانية. والثاني استخدام النموذج في عمليات الأعمال الداخلية: معالجة الطلبات الواردة، وتحليل الكلام في مركز الاتصال، وتصنيف المشكلات، وتقديم توصيات مخصصة بالخدمات.
ويتيح التركيز على اللغة الأذربيجانية تجنّب فقدان المعنى في الترجمة، ويضمن أن النموذج يفهم السياقات المحلية والفروق الدقيقة في الكلام.
ماذا يعني ذلك
هذا أول مثال علني على نموذج LLM متكامل الوظائف للغة الأذربيجانية جرى تطويره في بنية سحابية. وتُظهر الحالة أن المنصات السحابية قادرة على تكييف نماذج LLM ليس للغات النادرة فحسب، بل أيضًا لمهام صناعية محددة.
أما بالنسبة للشركات الأخرى في المنطقة، فهي إشارة بأن الاستثمار في نموذج لغوي خاص أمر واقعي، ويمكن إنجازه في غضون أسابيع قليلة.
- 28 أكتوبر 2026Anthropic تودع وثيقة S-1: إيرادات ربع سنوية بقيمة $11,6 مليار والتزامات بقيمة $780 مليار
- 27 أكتوبر 2026مفارقة 448 مليار دولار: لماذا لا تحقق 95% من المشاريع التجريبية للذكاء الاصطناعي في الشركات أي أثر على بيان الأرباح والخسائر
- 27 أكتوبر 2026BioStack تجمع 9.5 مليون دولار لتوفير بيانات تدريب الذكاء الاصطناعي الطبي
- 27 أكتوبر 2026Anthropic تقدّم نموذج S-1 إلى SEC: طرح عام أولي تحت الرمز ANT وإيرادات بقيمة 16,3 مليار دولار خلال نصف عام
أسئلة وأجوبة حول الخبر
ما أبرز التفاصيل حول لماذا تُعدّ أذربيجان حالة صعبة؟
اللغة الأذربيجانية مثال نموذجي على اللغات الإلصاقية ذات الصرف الغني. فالكلمة الواحدة قد تحمل عددًا كبيرًا من اللواحق التي تغيّر معناها ووظيفتها النحوية جذريًا. وهذا يستلزم مقاربات مختلفة تمامًا في تقسيم النص إلى رموز (tokenization) وفي تدريب النماذج، مقارنةً باللغات الهندو-أوروبية. ويُضاف إلى التعقيد الصرفي عامل حاسم: حجم بيانات التدريب المفتوحة المتاحة بالأذربيجانية أقل بكثير مما هو متاح للإنجليزية أو الروسية أو الإسبانية. ولا تنجح هنا مباشرةً الأساليب القياسية لتدريب LLM التي أثبتت فاعليتها على المدونات النصية الضخمة. يتطلب التعقيد الصرفي تقسيمًا خاصًا للنص إلى رموز شحّ ا
ما أبرز التفاصيل حول كيف حلّت Azercell المهمة؟
أبرمت الشركة شراكة مع AWS Generative AI Innovation Center. وخلال ستة أسابيع مكثفة من العمل المشترك، بنى مختصون من الجانبين إطار عمل جاهزًا للإنتاج على Amazon SageMaker. شمل الحل عدة مكونات أساسية: إعداد البيانات المتوفرة وتنظيفها على النحو الصحيح، وتقسيمًا متخصصًا للنص إلى رموز يراعي صرف اللغة الأذربيجانية، وتحسين عملية التدريب بحيث تعمل بحجم بيانات أقل. واستخدم المهندسون التعلّم بالنقل (transfer learning)، أي تكييف نماذج مدرَّبة مسبقًا بدلًا من التدريب من الصفر على مدونة نصية أذربيجانية.
ما أبرز التفاصيل حول ما النتيجة: دوران للنموذج؟
يعمل نموذج Azercell في اتجاهين. الأول روبوت دردشة موجّه إلى العملاء (customer-facing) يساعد المشتركين في الاستفسار عن الخدمات والباقات باللغة الأذربيجانية. والثاني استخدام النموذج في عمليات الأعمال الداخلية: معالجة الطلبات الواردة، وتحليل الكلام في مركز الاتصال، وتصنيف المشكلات، وتقديم توصيات مخصصة بالخدمات. ويتيح التركيز على اللغة الأذربيجانية تجنّب فقدان المعنى في الترجمة، ويضمن أن النموذج يفهم السياقات المحلية والفروق الدقيقة في الكلام.
Test Frontier LLMs & Autonomous Agents in One Workspace
Run Claude Opus 5.5, GPT-6, Gemini 3.1, and DeepSeek side-by-side in Nomad AI (nomadnet.ai) — unified model routing, deep research, and multimodal workflows under one subscription.
أهم ما في عالم الذكاء الاصطناعي — مرة كل أسبوع
سبع قصص مهمة فعلاً هذا الأسبوع، مختارة بعناية. بلا ضجيج ولا بيانات صحفية.
تم! تحقق من بريدك للتأكيد.